训练 Tesseract 来标记图标
我正在尝试为 Tesseract 4.0 创建训练数据来识别屏幕截图中的图标(例如,评论,分享,保存)。这是一个示例屏幕截图:
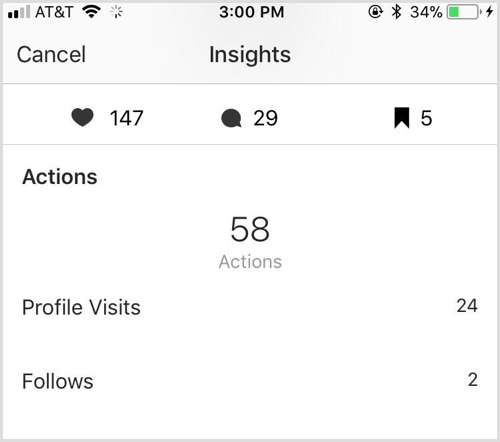
我想微调 Tesseract 以实现如下输出:
Like 147
Comment 29
Saved 5
Actions
58
Actions
Profile Visits 24
Follows 2
我已按照https://pretius.com/how-to-prepare-training-files-for-tesseract-ocr-and-improve-characters-recognition/中所述逐步进行操作
我修改了盒子文件如下:
- 心:喜欢
- 语音气泡:评论
- 书签:已保存
- 箭头:分享
但是,最终的训练数据未能按照我想要的方式读取图标。我遇到的错误示例是“Like is not in unicharset”。在为图标创建 unicharset 时我需要做一些不同的事情吗?
我已经弄清楚了。框编辑器需要单个字母/数字而不是完整的单词。我使用 Unicode 字符来解释我的图标。步骤如下:
- 裁剪您希望 Tesseract 检测的所有目标图标并将其保存在一个名为(在我的例子中)own.std.exp0.png 的文件中
- 使用命令 'tesseract own.std.exp0.png own.std.exp0 makebox' 创建 box 文件
- 打开jTessBoxEditor并在char列输入unicode。支持的 unicode 列表可以在程序字符映射表 ( https://sites.psu.edu/symbolcodes/windows/charmap/ ) 下找到。示例:对于心形符号,我使用 U+2665。请注意,不支持某些 unicode。它显示为空白方块。所以,继续尝试,直到找到一个有效的方法。我最终编辑的盒子文件如下所示。

- 创建最终的训练文件,该文件将是 own.trainneddata (可以按照此处所示完成https://medium.com/apegroup-texts/training-tesseract-for-labels-receipts-and-such-690f452e8f79或使用 jTessBoxEditor 进行训练) 。
- 将 own.traineddata 复制到目录 Tesseract/tessdata 并使用 lang='own+eng' 运行 Tesseract。我使用了 pytesseract ,输出如下:

| 归档时间: |
|
| 查看次数: |
2568 次 |
| 最近记录: |