在Rcpp中决定NumericVector和arma :: vec
使用RcppArmadillo,从R到Rcpp的转换arma::vec就像使用Rcpp和Rcpp一样简单NumericVector.我的项目使用RcppArmadillo.
我不确定要使用什么,NumericVector或者arma::vec?这两者之间的主要区别是什么?什么时候用哪个?使用一个优于另一个是否有性能/内存优势?成员职能的唯一区别是什么?并且,作为一个奖金问题:我应该考虑arma::colvec还是arma::rowvec?
coa*_*ess 20
这两者之间的主要区别是什么?
Rcpp中的*Vector和*Matrix类充当R的SEXP表示的包装,例如作为指向数据的指针的S表达式.有关详细信息,请参阅第1.1节SEXPs的[R内幕.Rcpp的设计通过从包含指向数据的指针的类构造C++对象来利用这一点.这促进了两个关键特征:
- R和C++对象之间的无缝转换,以及
- R和C++之间的转移成本低,因为只传递指针.
- 因为数据没有复制但是被引用
同时,arma对象是类似于传统的std::vector<T>在一个方式深的之间发生复制- [R和C++的对象.有一个例外声明中,存在高级构造,其允许后面的存储器ř对象物进行再利用的内部armadillo对象的结构.因此,如果您不小心,在从R到C++的过渡期间可能会受到不必要的惩罚,反之亦然.
注意:不存在允许重用内存的高级构造函数arma::sp_mat.因此,使用具有稀疏矩阵的引用可能不会产生所需的加速,因为从R到C++执行复制并返回.
您可以在很大程度上基于"pass-by-reference"或"pass-by-copy"范例来查看差异.要了解代码之外的差异,请考虑mathwarehouse的以下GIF :
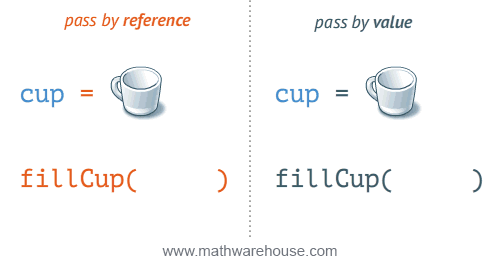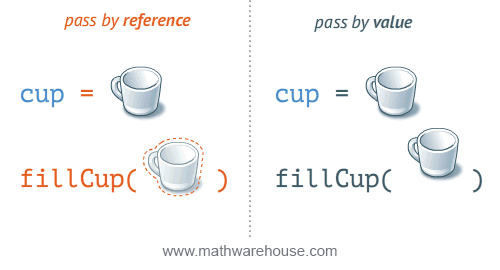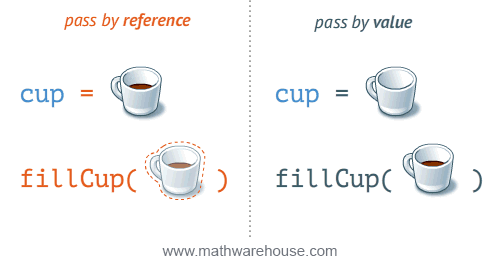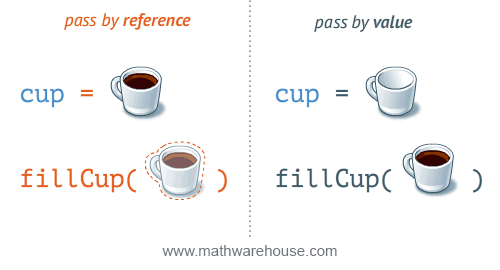
要在代码中说明此场景,请考虑以下三个函数:
#include <RcppArmadillo.h>

// [[Rcpp::depends(RcppArmadillo)]]

// [[Rcpp::export]]
void memory_reference_double_ex(arma::vec& x, double value) {
    x.fill(value);
}

// [[Rcpp::export]]
void memory_reference_int_ex(arma::ivec& x, int value) {
    x.fill(value);
}

// [[Rcpp::export]]
arma::vec memory_copy_ex(arma::vec x, int value) {
    x.fill(value);
    return x;
}
这两个函数memory_reference_double_ex()和memory_reference_int_ex()将更新对象内部的ř假定适当的数据类型是存在的.因此,我们可以避免通过void在其定义中指定来返回值,因为x正在重用的内存被重用.第三个函数memory_copy_ex()需要返回类型,因为它是逐个复制的,因此,如果没有重新分配调用,则不会修改现有存储.
强调:
- 该
x向量将通过引用传递给C++,例如&在arma::vec&or 的末尾arma::ivec&,和 - 类的
x在[R是任一double或integer这意味着我们是匹配的基础类型的arma::vec,例如Col<double>,或者arma::ivec,例如Col<int>.
让我们快速看看两个例子.
在第一个示例中,我们将查看运行结果memory_reference_double_ex()并将其与生成的结果进行比较 memory_copy_ex().注意,R和C++中定义的对象之间的类型是相同的(例如double).在下一个例子中,这将不成立.
x = c(0.1, 2.3, 4.8, 9.1)
typeof(x)
# [1] "double"

x
# [1] 0.1 2.3 4.8 9.1

# Nothing is returned...
memory_reference_double_ex(x, value = 9)

x
# [1] 9 9 9 9

a = memory_copy_ex(x, value = 3)

x
# [1] 9 9 9 9

a
#      [,1]
# [1,]    3
# [2,]    3
# [3,]    3
# [4,]    3
现在,如果R对象的基础类型是一个integer而不是一个double?
x = c(1L, 2L, 3L, 4L)
typeof(x)
# [1] "integer"

x
# [1] 1 2 3 4

# Return nothing...
memory_reference_double_ex(x, value = 9)

x
# [1] 1 2 3 4
发生了什么?为什么没有x更新?好吧,在幕后,Rcpp创建了一个新的内存分配,它是正确的类型 - double而不是int- 在传递之前armadillo.这导致两个对象之间的引用"链接"不同.
如果我们更改为在armadillo向量中使用整数数据类型,请注意我们现在具有前面给出的相同效果:
memory_reference_int_ex(x, value = 3)

x
# [1] 3 3 3 3
这导致讨论这两种范式的有用性.由于速度是使用C++时的首选基准,让我们根据基准来看待这一点.
考虑以下两个功能:
#include <RcppArmadillo.h>

// [[Rcpp::depends(RcppArmadillo)]]

// [[Rcpp::export]]
void copy_double_ex(arma::vec x, double value) {
    x.fill(value);
}

// [[Rcpp::export]]
void reference_double_ex(arma::vec& x, double value) {
    x.fill(value);
}
在它们上面运行微基准测试产生:
# install.packages("microbenchmark")
library("microbenchmark")

x = rep(1, 1e8)

micro_timings = microbenchmark(copy_double_ex(x, value = 9.0),
                               reference_double_ex(x, value = 9.0))
autoplot(micro_timings)
micro_timings

# Unit: milliseconds
#                               expr       min        lq      mean    median        uq      max neval
#       copy_double_ex(x, value = 9) 523.55708 529.23219 547.22669 536.71177 555.00069 640.5020   100
#  reference_double_ex(x, value = 9)  79.78624  80.70757  88.67695  82.44711  85.73199 308.4219   100

注:引用的对象〜每次迭代更快的6.509771倍的复制模式,因为我们不具备重新分配,并填写内存.
什么时候用哪个?
你需要做什么?
您是否只是想快速加速依赖循环但不需要严格的线性代数操作的算法?
如果是这样,只需使用Rcpp就足够了.
你在尝试进行线性代数操作吗?或者您希望在多个库或计算平台(例如MATLAB,Python,R,...)中使用此代码?
如果是这样,你应该写算法的症结在犰狳和建立相应的钩子函数导出为[R与RCPP.
使用一个优于另一个是否有性能/内存优势?
是的,如前所述,肯定有性能/内存优势.不仅如此,通过使用RcppArmadillo,您有效地在Rcpp上添加了一个额外的库,从而增加了整体安装空间,编译时间和系统要求(参见macOS构建的困境).搞清楚什么是你的项目所需要的,然后选择该结构.
成员职能的唯一区别是什么?
不仅是成员函数,还有:
- 基于矩阵分解的估计程序
- 计算统计数量值
- 对象生成
- 稀疏表示(避免操纵S4对象)
这些是Rcpp和犰狳之间的根本区别.一个用于促进R对象转移到C++中,而另一个用于更严格的线性代数计算.这应该是主要显而易见的,RCPP并没有实现任何矩阵乘法的逻辑,而采用该系统的基本线性代数子程序(BLAS)来进行计算.armadillo
而且,作为一个额外的问题:我应该考虑arma :: colvec或arma :: rowvec?
取决于您希望如何返回结果.你想要一个:( 1 x N行向量)还是N x 1(列向量)?RcppArmadillo默认情况下,将这些结构作为具有适当尺寸的矩阵对象返回,而不是传统的1D R向量.
举个例子:
#include <RcppArmadillo.h>

// [[Rcpp::depends(RcppArmadillo)]]

// [[Rcpp::export]]
arma::vec col_example(int n) {
    arma::vec x = arma::randu<arma::vec>(n);
    return x;
}


// [[Rcpp::export]]
arma::rowvec row_example(int n) {
    arma::rowvec x = arma::randu<arma::rowvec>(n);
    return x;
}
测试:
set.seed(1)
col_example(4)
#           [,1]
# [1,] 0.2655087
# [2,] 0.3721239
# [3,] 0.5728534
# [4,] 0.9082078

set.seed(1)
row_example(4)
#           [,1]      [,2]      [,3]      [,4]
# [1,] 0.2655087 0.3721239 0.5728534 0.9082078
@coatless的答案是正确的,但会让您无所适从。
同时,您的问题未明确指定,因为您未指出需要向量的用途。有了这个警告,我会说
- 对于简单用例,Rcpp很好,而RcppArmadillo也很好
- 对于需要线性代数的用例,更喜欢RcppArmadillo
- 性能将在很大程度上等效,但需要注意的是,您需要针对RcppArmadillo进行明确的“按引用调用”
- 只读向量访问(例如,类似
sum()或min()或查找的简化)与读写访问之间也有很大的区别,这关系到如何返回修改后的向量 - 通常,所有用例都比R代码快得多,因此,首先不要着迷于此。
一旦设置正确,就可以(也许应该)配置文件。
| 归档时间: |
|
| 查看次数: |
1142 次 |
| 最近记录: |