一对多和多对一关系之间的差异
Zha*_*haf 110 sql relational-algebra relational-database
一对多和多对一关系之间的真正区别是什么?它只是逆转了,那种?
除了这个之外,我找不到任何关于这个主题的"好的和易于理解的"教程:初学者的SQL:第3部分 - 数据库关系
Dev*_*van 101
是的,反之亦然.这取决于实体所在的关系的哪一方.
例如,如果一个部门可以雇用几个员工,那么部门与员工之间是一对多关系(1个部门雇用了许多员工),而员工与部门之间的关系是多对一(许多员工在一个部门工作).
关于关系类型的更多信息:
- 我担心不会制作场景!(**不确定但是**)我认为订单代表依赖!不是吗?EG,用户角色可以是1对多但不是多对一,因为无法获得使用该角色的用户的引用!那有意义吗? (2认同)
Gra*_*ray 16
一对多和多对一关系之间的真正区别是什么?
这些术语之间存在概念上的差异,这些术语应该有助于您可视化数据,以及应该完全理解的生成架构中的可能差异.但大多数情况下,差异是透视之一.
在一对多关系中,本地表有一行可能与另一个表中的许多行相关联.在初学者的SQL示例中,Customer可以将一个与许多Orders 相关联.
在相反的多对一关系中,本地表可能有许多行与另一个表中的一行相关联.在我们的例子中,许多Orders可能与一个相关联Customer.这种概念差异对于心理表征很重要.
另外,支持关系的模式可以在Customer和Order表中以不同方式表示.例如,如果客户有列id,则name:
id,name
1,Bill Smith
2,Jim Kenshaw
然后,Order为了与a关联Customer,许多SQL实现向Order表中添加一个存储id关联的列Customer(在此模式中customer_id:
id,date,amount,customer_id
10,20160620,12.34,1
11,20160620,7.58,1
12,20160621,158.01,2
在上面的数据行中,如果我们查看customer_idid列,我们会看到Bill Smith(customer-id#1)有2个与他相关的订单:一个是12.34美元,一个是7.58美元. Jim Kenshaw(customer-id#2)只有1个订单,158.01美元.
重要的是要意识到,通常一对多关系实际上不会向表中添加任何列,即"一".在Customer具有描述与关系没有额外列Order.实际上,Customer也可能ShippingAddress与SalesCall表有一对多的关系,但没有向Customer表中添加其他列.
但是,对于要描述的多对一关系,通常会将一id列添加到"many"表中,该表是"one"表的外键 - 在这种情况下,将一customer_id列添加到Order.要将订单#10与$ 12.34相关联Bill Smith,我们将customer_id列指定为Bill Smithid 1.
但是,也可能存在另一个描述Customer和Order关系的表,因此不需要向Order表中添加其他字段.不是添加的customer_id字段的Order表,有可能是Customer_Order表包含键同时Customer和Order.
customer_id,order_id
1,10
1,11
2,12
在这种情况下,一对多和多对一都是概念性的,因为它们之间没有架构变化.哪种机制取决于您的架构和SQL实现.
希望这可以帮助.
- 一般情况称为包含依赖.外键约束是包含依赖项的最常见类型,但并非所有包含依赖项都涉及外键.公共属性("引用")始终存在于*both*tables中.在"一"侧,这些属性称为候选键.在"许多"方面,他们*可能*是外键.术语"一对多"或"多对一"可以应用于涉及至少一个候选键的任何包含依赖性,而不一定暗示哪一侧可以是可选的. (3认同)
- 问题是关系数据库和SQL,而不是Java.也许你对Java是正确的. (2认同)
- 我说这些是描述完全相同关系的两种方式,但是从不同的角度来看.与"A是B的子集"相同的方式与"B是A的超集"相同. (2认同)
小智 6
你的第一个问题的答案是:两者都相似,
回答你的第二个问题是:一对多 - >一个MAN(MAN表)可能有一个以上的妻子(妇女表)多对一 - >多个女人嫁给一个MAN.
现在,如果要将此关系与两个表MAN和WOMEN相关联,则一个MAN表行可能与WOMEN表中的行有很多关系.希望它清楚.
- 被否决了,你应该想出一个比一夫多妻制更合适的例子 (2认同)
SQL
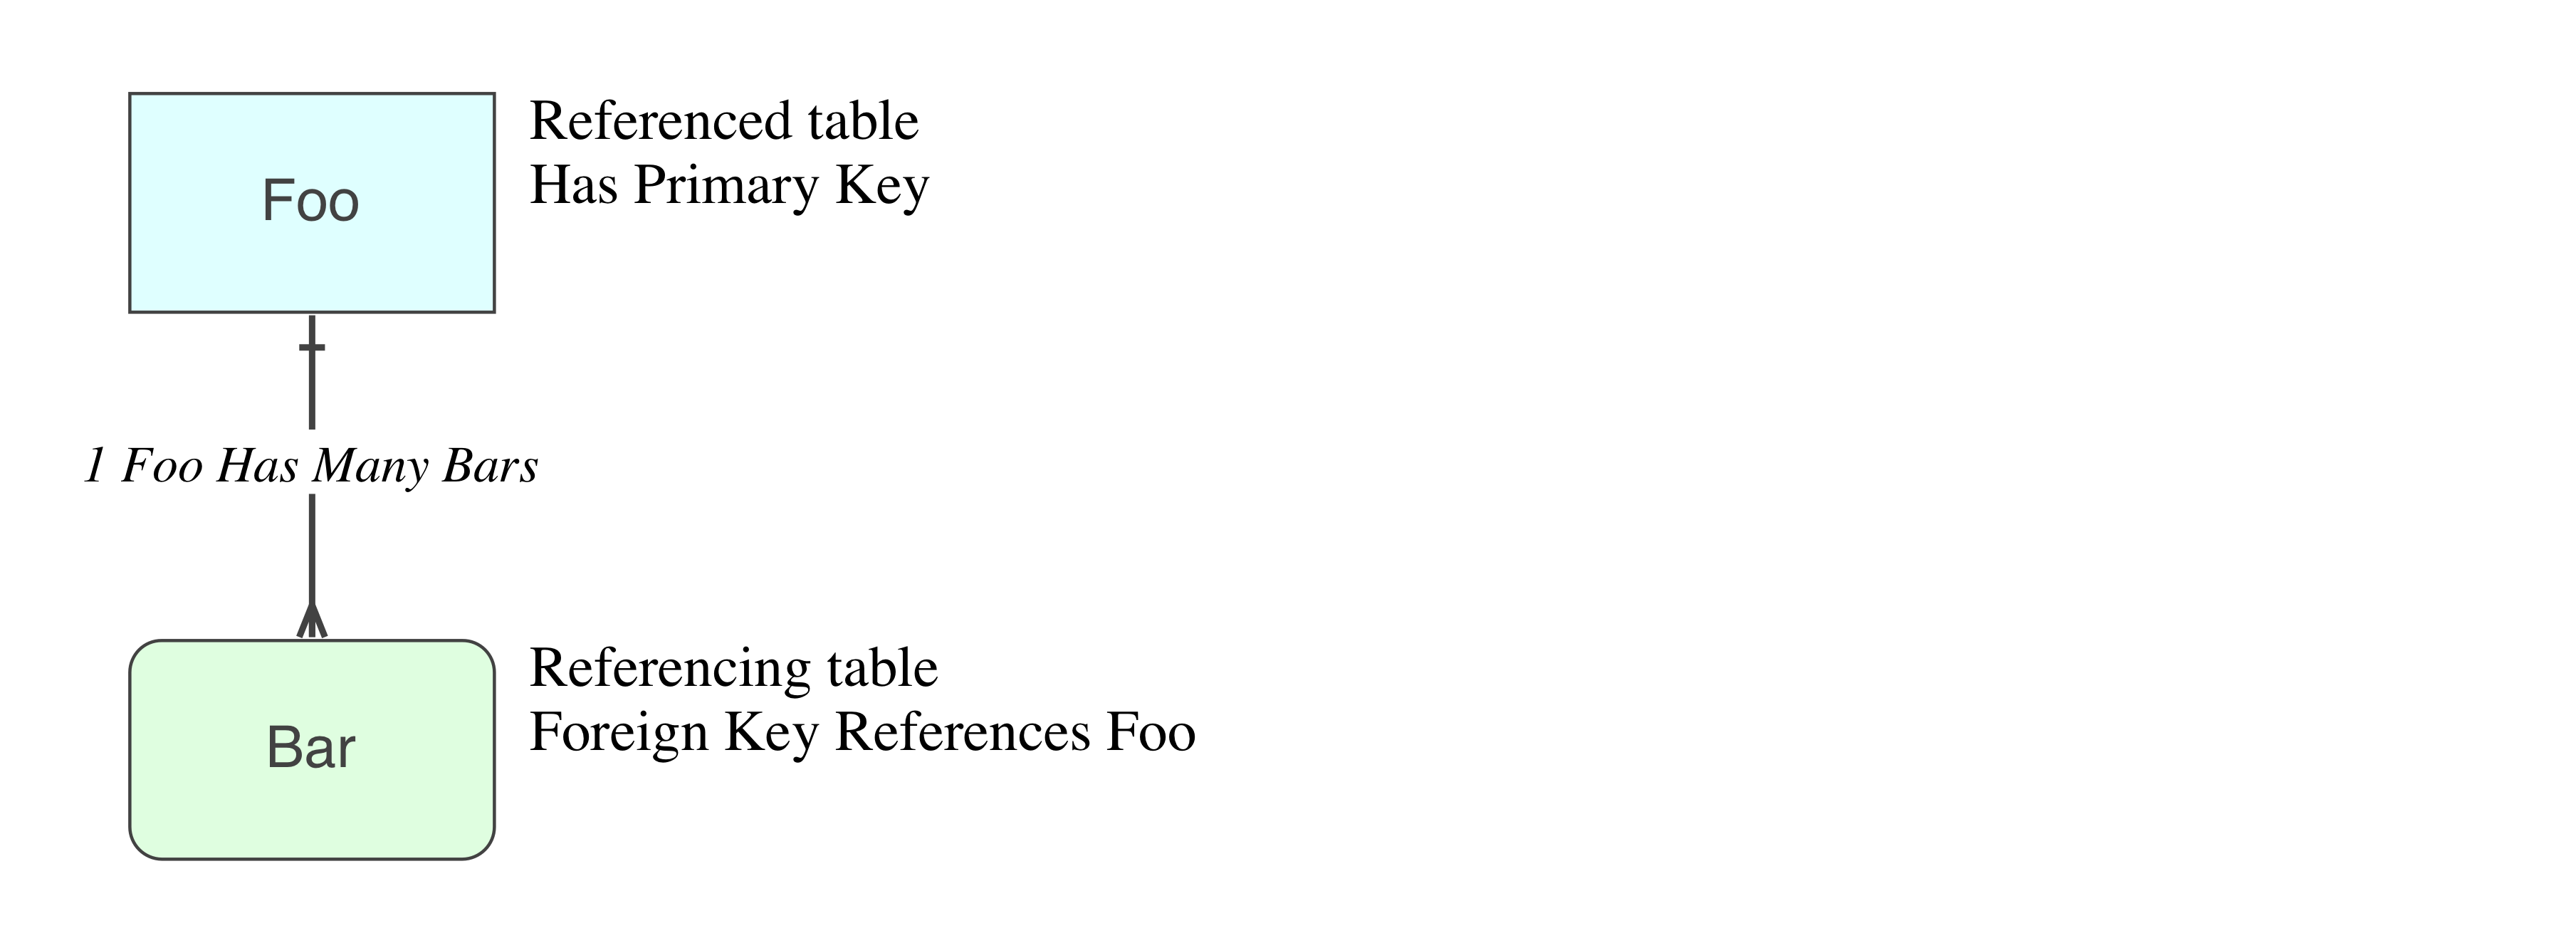
在 SQL 中,只有一种关系,称为引用。(您的前端可能会做有用或令人困惑的事情 [例如在某些答案中],但那是另一回事。)
一个外键在一个表(和借鉴荷兰国际集团表)
引用
一个主键在另一表(和借鉴编表)在 SQL 术语中,Bar 引用 Foo 而
不是相反
Run Code Online (Sandbox Code Playgroud)CREATE TABLE Foo ( Foo CHAR(10) NOT NULL, -- primary key Name CHAR(30) NOT NULL CONSTRAINT PK -- constraint name PRIMARY KEY (Foo) -- pk ) CREATE TABLE Bar ( Bar CHAR(10) NOT NULL, -- primary key Foo CHAR(10) NOT NULL, -- foreign key to Foo Name CHAR(30) NOT NULL CONSTRAINT PK -- constraint name PRIMARY KEY (Bar), -- pk CONSTRAINT Foo_HasMany_Bars -- constraint name FOREIGN KEY (Foo) -- fk in (this) referencing table REFERENCES Foo(Foo) -- pk in referenced table )由于
Foo.Foo是主键,所以它是唯一的,任何给定的值只有一行Foo由于
Bar.Foo是一个引用,一个外键,并且没有唯一的索引,对于任何给定的值可以有很多行Foo因此关系
Foo::Bar是一对多的现在你可以反过来感知(看)这种关系,
Bar::Foo是多对一的- 但是,不要让这种混淆你:对于任何一个
Bar排,只有一个Foo排它引用
- 但是,不要让这种混淆你:对于任何一个
在 SQL 中,这就是我们所拥有的。这就是所有必要的。
一对多和多对一关系之间的真正区别是什么?
只有一种关系,因此没有区别。感知(从一个“端”或另一个“端”)或向后阅读,不会改变关系。
基数
基数首先在数据模型中声明,这意味着逻辑和物理(意图),然后在实现中(意图实现)。
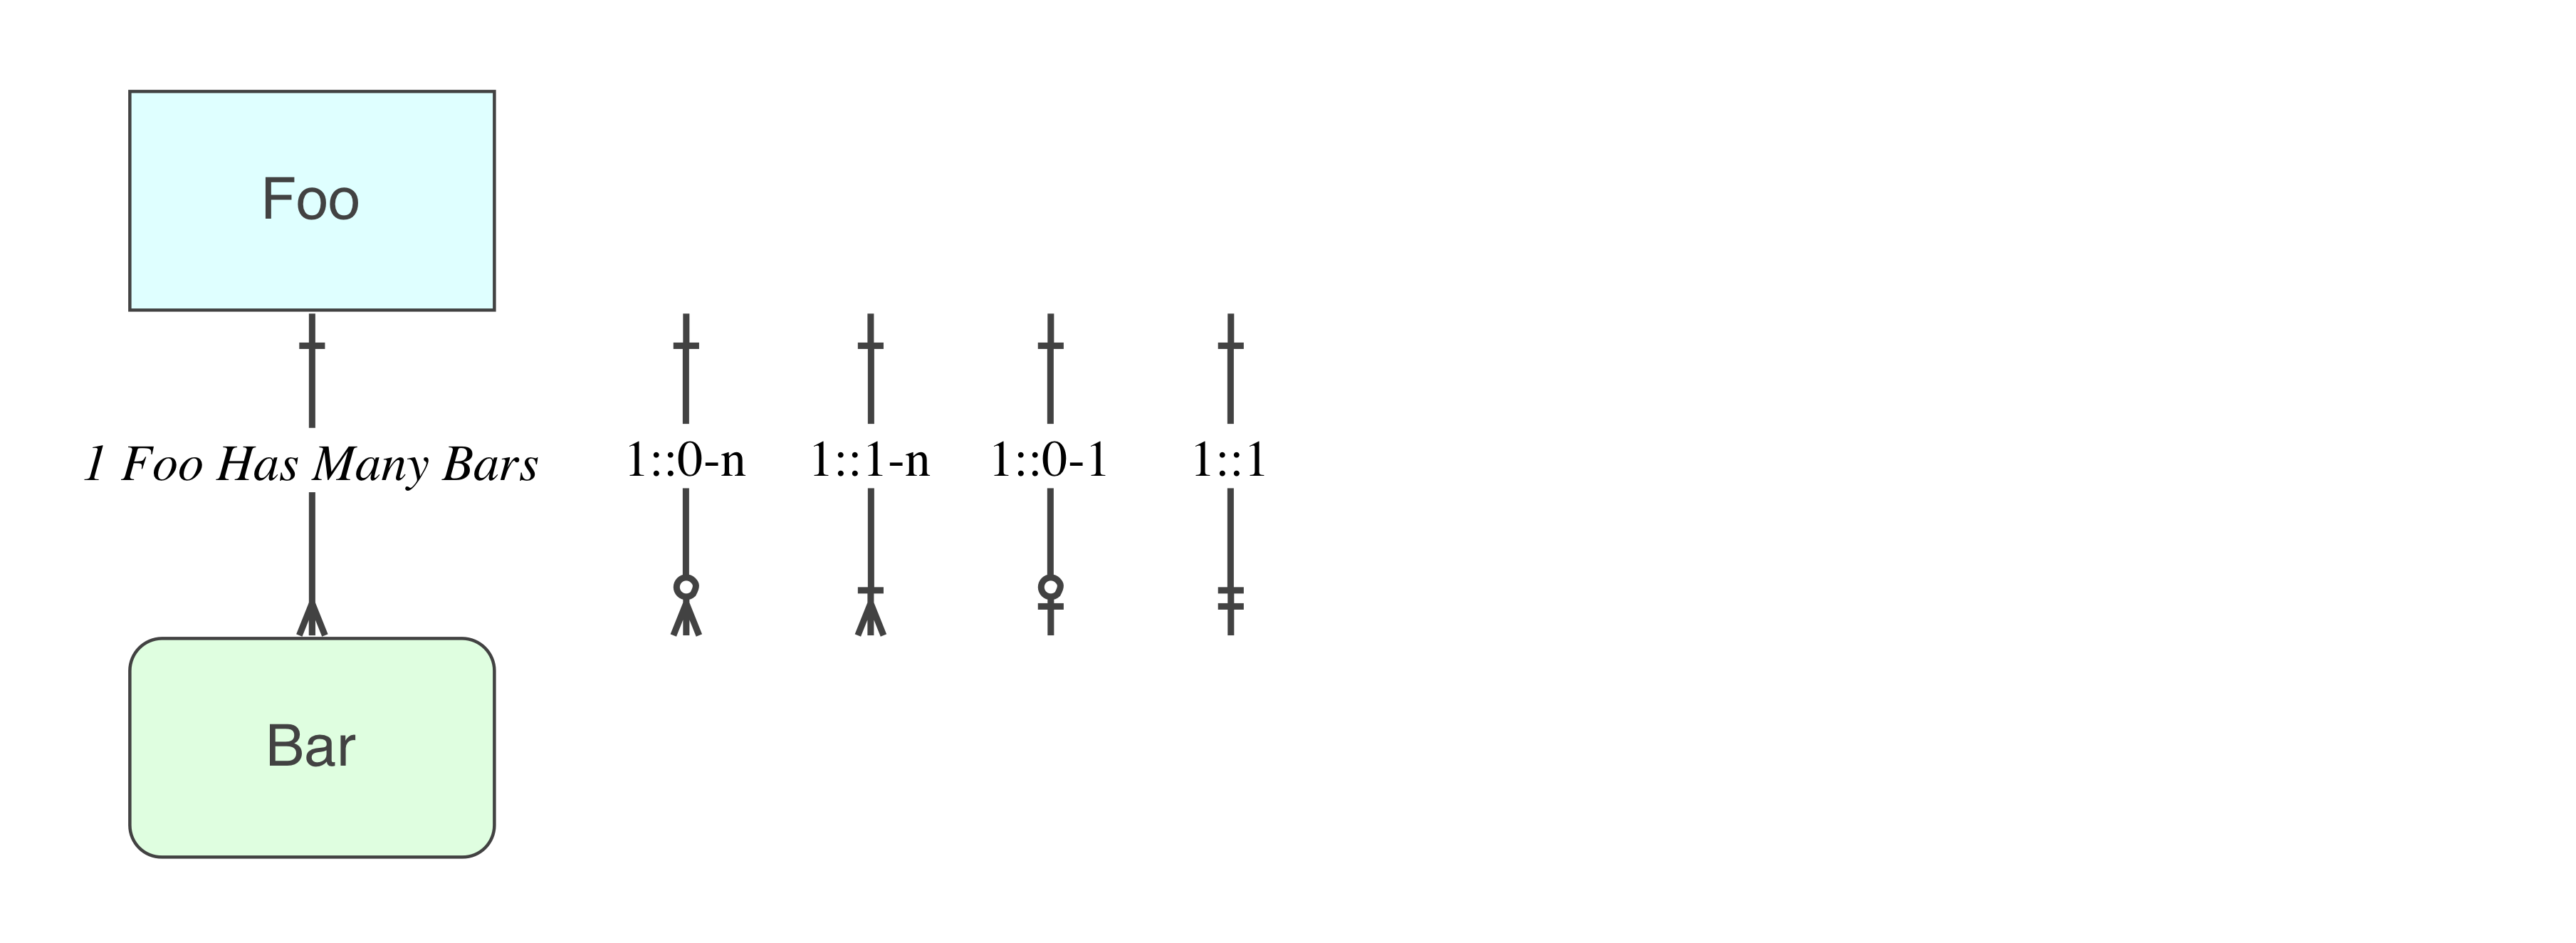
一对零对多
在 SQL 中,(以上)就是所需要的。
一对一
您需要一个事务来强制执行引用表中的一个。
一对零对一
您需要Bar:
CONSTRAINT AK    -- constraint name
    UNIQUE (Foo) -- unique column, which makes it an Alternate Key
一对一
您需要一个事务来强制执行引用表中的事务。
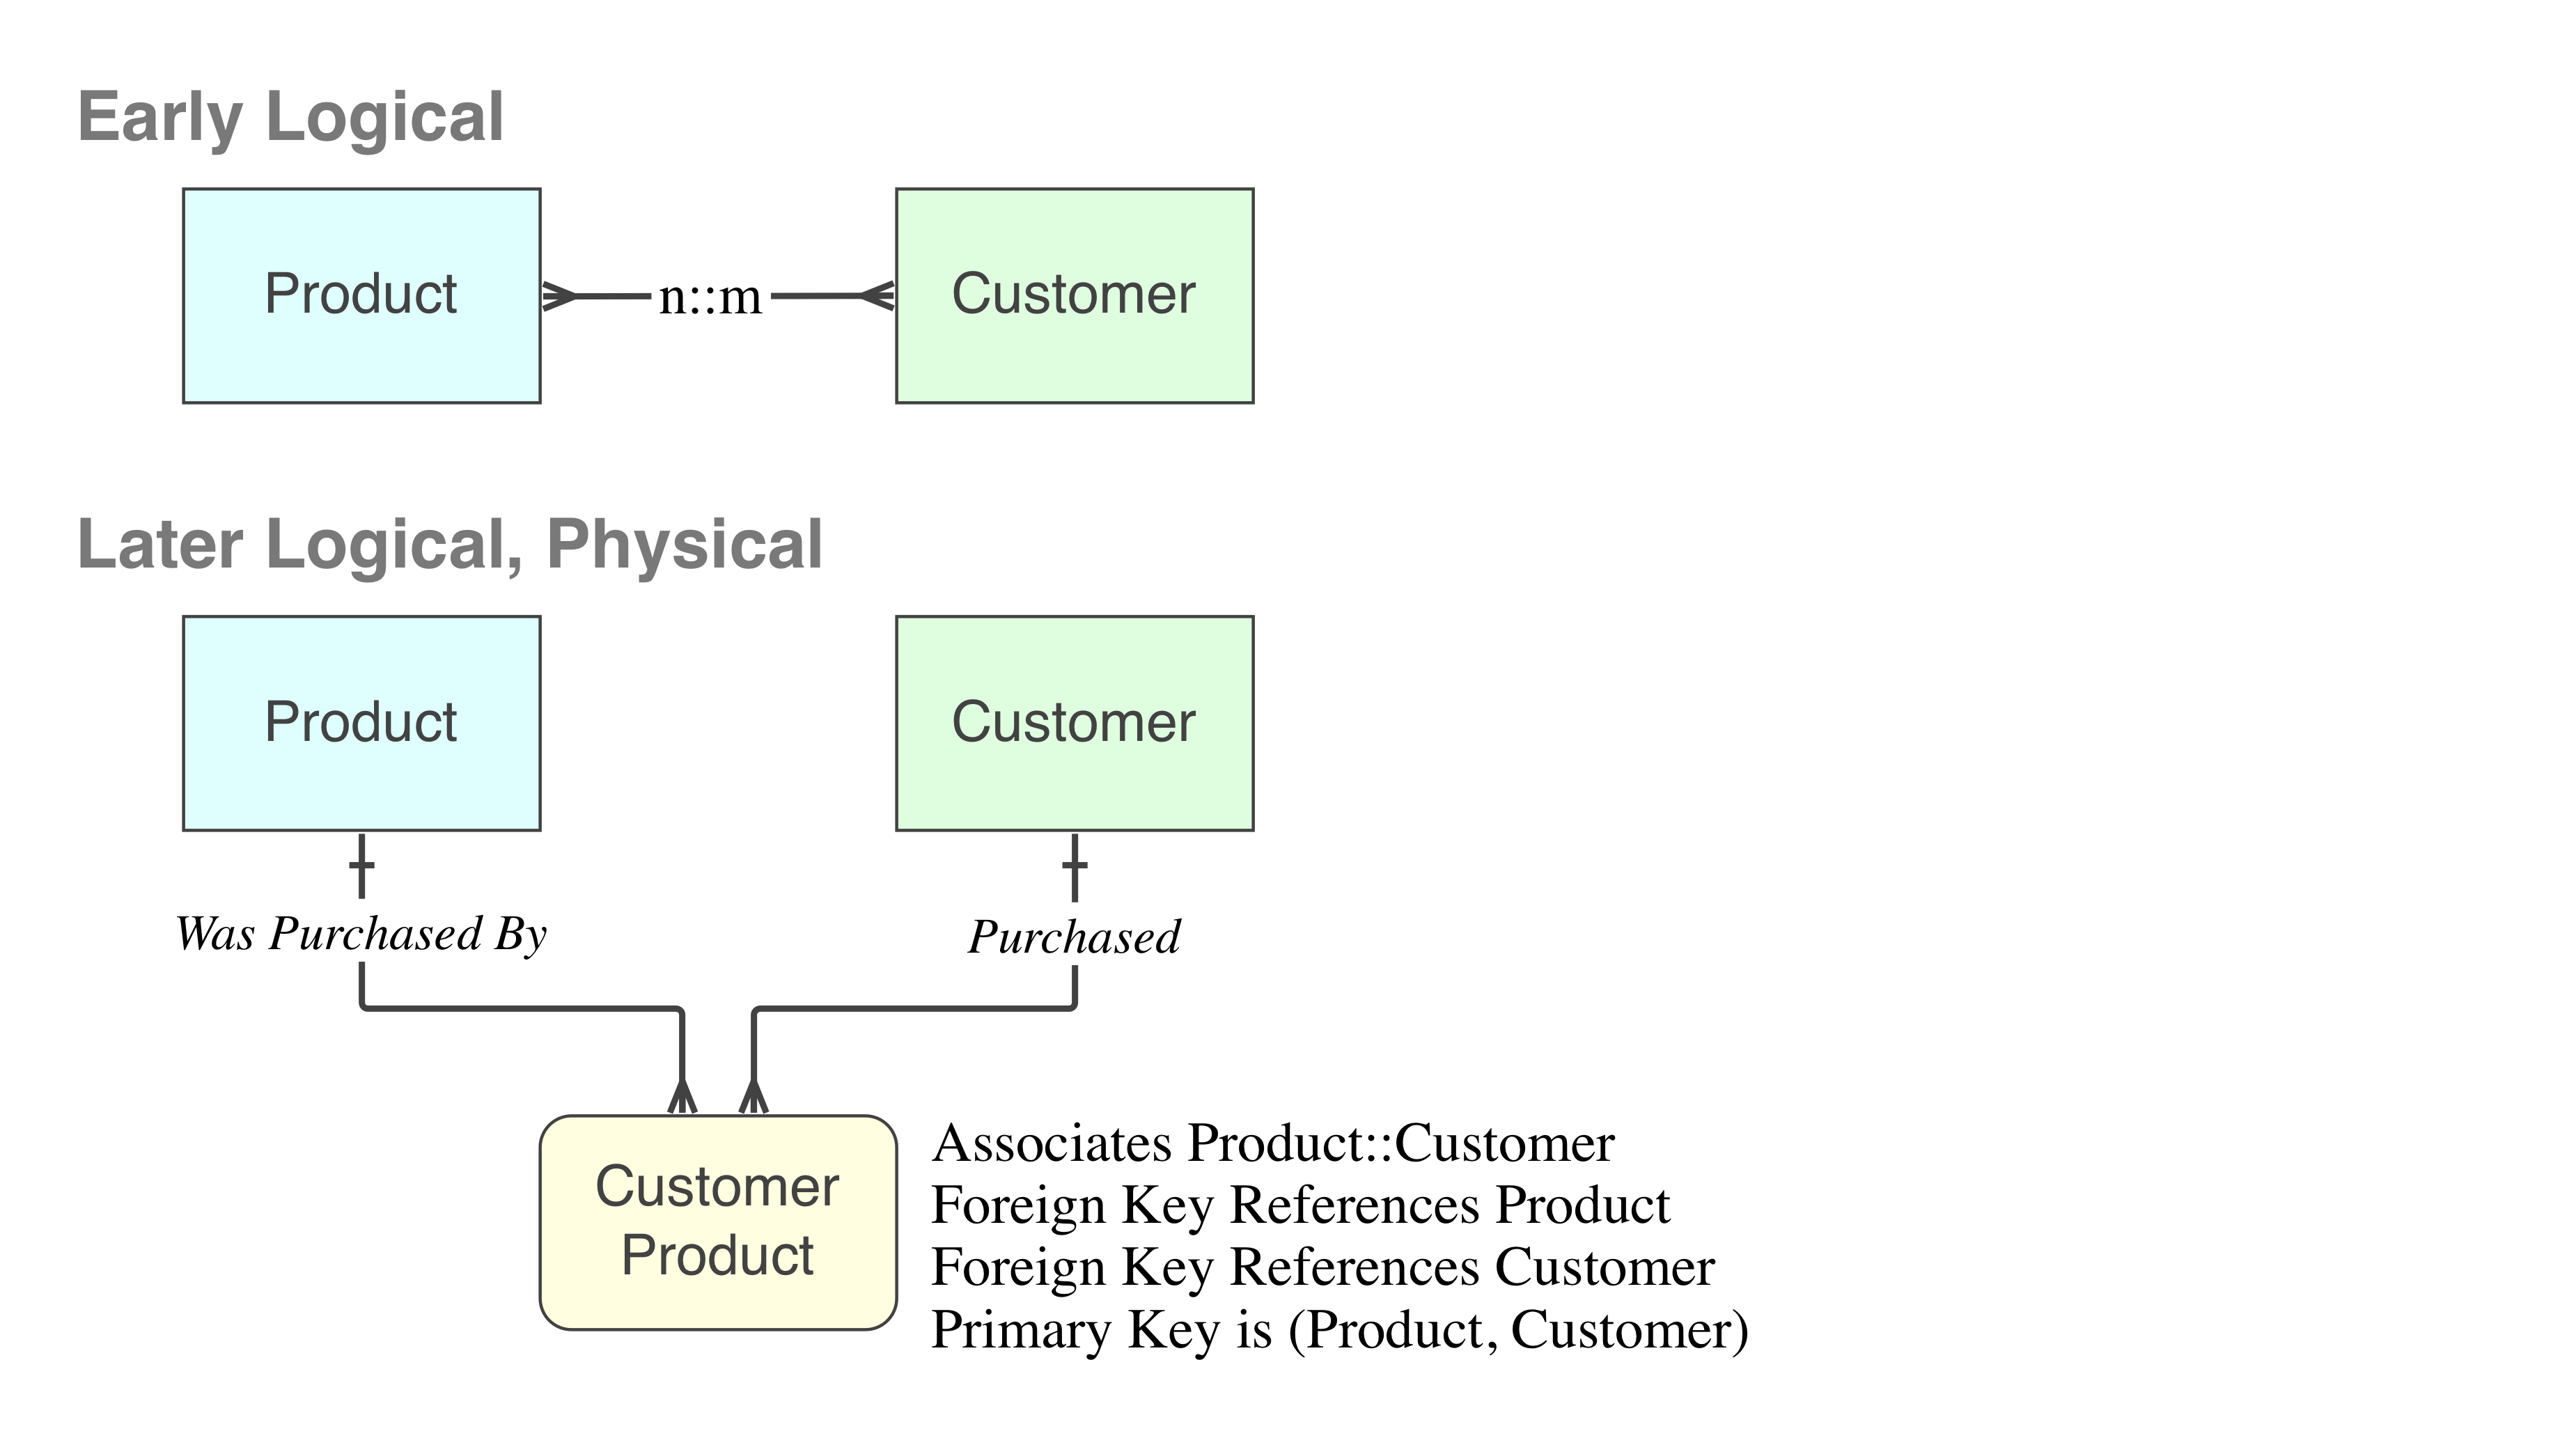
多对多
在物理级别没有这样的事情(回想一下,SQL 中只有一种类型的关系)。
在建模练习期间的早期逻辑级别,绘制这样的关系很方便。在模型接近实现之前,最好将其提升为仅使用可以存在的东西。这种关系是通过在物理 [DDL] 级别实现关联表来解决的。
- 找到一种不同的方式来表达这些事情,而不是诉诸于咆哮、辱骂和诽谤任何人的智力或职业行为。专注于技术,而不是那些可能会或不会错的人。 (3认同)
没有区别。这只是一个语言和偏好的问题,关于你用哪种方式来陈述这种关系。
- @灰色的。不,那里没有。您的答案不仅不正确,而且使初学者(提出此问题的人)感到困惑。 (4认同)
- 无论是概念上还是生成的模式,这肯定是有区别的。看我的回答:http://stackoverflow.com/a/37954280/179850 (2认同)
一对多和多对一在多重性上相似,但在方面(即方向性)不相似。
实体类之间的关联映射和表之间的关系。有两类关系:
- 多重性(ER 术语:基数)
- 一对一的关系(缩写为1:1):以夫妻为例
- 一对多关系(缩写为 1:N):示例母亲和孩子
- 多对多关系(缩写为 M:N):示例学生和主题
- 方向性:不会影响映射,但会影响我们访问数据的方式。
- 单向关系:引用其他实体的关系字段或属性。
- 双向关系:每个实体都有一个关系字段或属性来引用另一个实体。