use*_*112 2 cpu caching intel cpu-architecture tlb
我正在观察最后几个英特尔微体系结构(Nehalem/SB/IB和Haswell).我正在尝试解决发生数据请求时发生的事情(在相当简化的级别).到目前为止,我有这个粗略的想法:
在这一点上,可能会发生两件事,一件未命中或一件事:
如果它命中了CPU,那么按顺序尝试L1D/L2/L3缓存,页表和主内存/硬盘?
如果它错过了 - CPU请求(集成内存控制器?)请求检查RAM中保存的页表(我是否在那里得到了IMC的角色?).
如果有人可以编辑/提供一组项目符号,这些项目提供CPU对执行引擎数据请求所做的基本"概述",包括
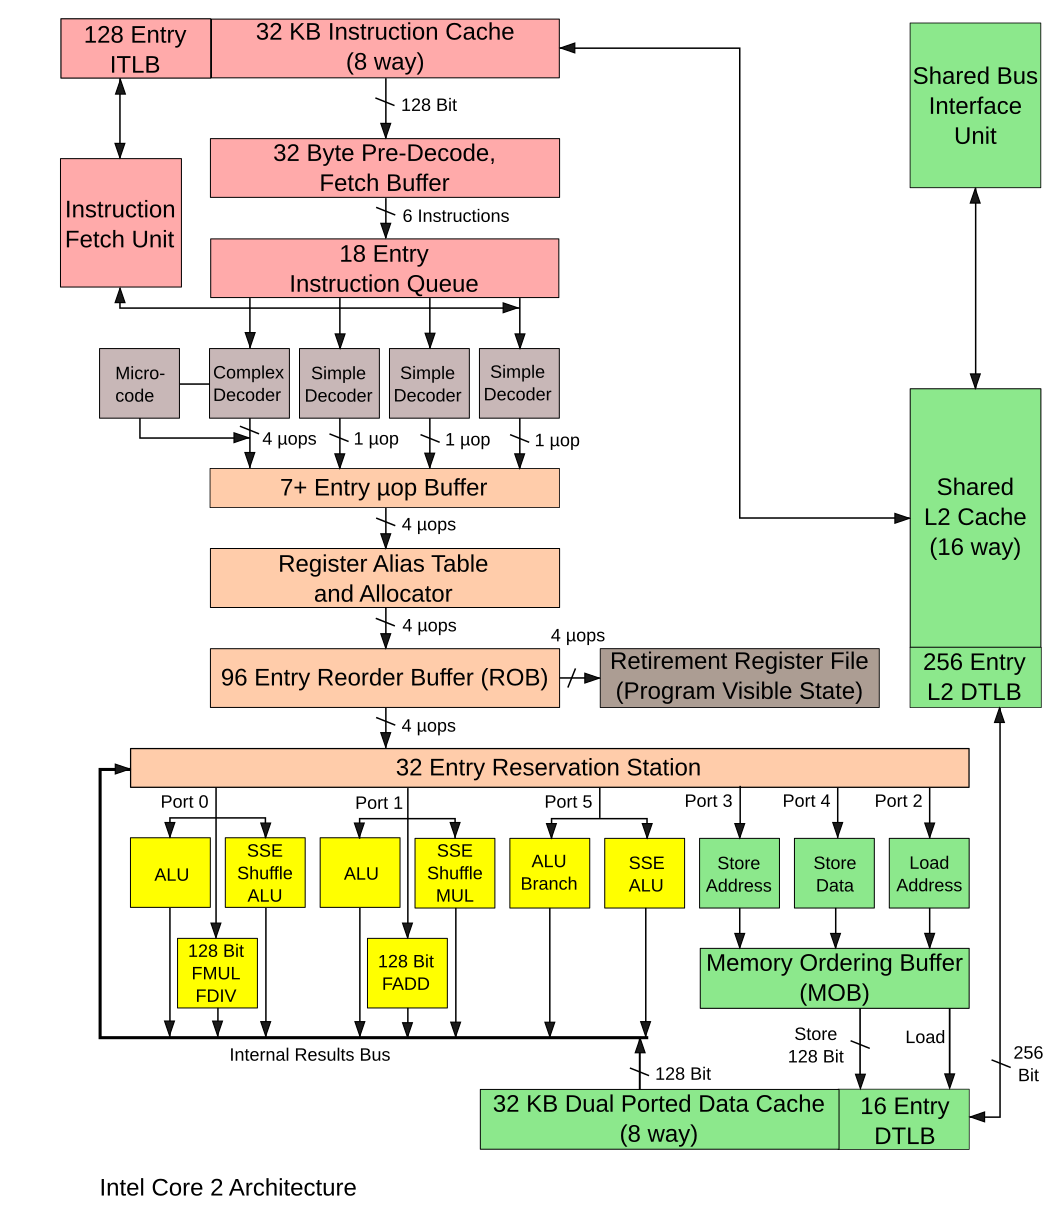
非常感谢.我找到了一些有用的图片:
但他们并没有真正区分TLB和缓存之间的相互作用.
更新:改变了上述内容,因为我认为我现在明白了.TLB只从虚拟地址获取物理地址.如果错过了 - 我们遇到了麻烦,需要检查页面表.如果有一个命中,我们只需从L1D缓存开始向下遍历内存层次结构.
页面映射仅适用于虚拟到物理地址转换.但是,由于它驻留在内存中并且仅部分缓存在TLB中,因此您可能必须在转换过程中访问它.
基本流程如下:
如果需要页面行走,则停止主要请求,并向页面映射发出物理负载(根据体系结构定义).在x86中,它可能包括CR3,PDPTR,PDP,PDE,PTE等.取决于分页模式,页面大小等.请注意,在虚拟化下,VM上的每个页面行走级别可能需要在主机上进行完整的分页(所以你实际上平方所需的步数).
请注意,页面映射基本上是一种树结构,其中每次访问都取决于前一个(以及您翻译的虚拟地址的一部分)的值.因此,这些访问是相关的,只有在最后一次访问完成后,您才能获得物理地址,并且可以返回到#3.一直以来,你想要的线路可能都坐在你的L1里而你却无法知道(虽然说实话,如果你做了一次网页漫步,你不太可能仍然在你的上部缓存中有线).
其他重要说明 - 页面映射在物理空间中并以此方式访问.您不希望翻译转换所需的访问,这可能是一个死锁:)
更重要的是,页面映射数据可以被缓存,因此由于TLB未命中,简单的内存访问可能会扩展为多个,页面漫步可能仍然相当便宜.
| 归档时间: |
|
| 查看次数: |
1651 次 |
| 最近记录: |