javascript正则表达式在第一个等号分隔字符串
这是我试图在文本文件中识别的字符串.文本文件具有我需要在每行中提取的特定字段.例如:
Field1 = This is the content for field 1
Field2 = This is the content for field 2
Field3 = This is the content for field 3, which is = to 4445
假设我想在第一个"="符号后提取field3的内容.如何获取该内容"这是字段3的内容,即= 4445",包括第二个"="符号,但不是第一个.我正在进入正则表达式,所以我没有多少经验.这是我尝试过的:
=.*
但这将打印出第一个"="符号及其后的所有内容.我想省略第一个=符号.
同样,在没有第一个"="符号的情况下获得"Field3"的正则表达式是什么?我知道我可以根据第一个等号分割线,但我真的需要用regexp来做.谢谢
.*?=\s*(.*)
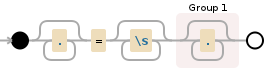
.表示除换行符之外的所有字符+意味着另外一个角色()表示捕获组*意味着零或更多\s意味着白色空间*?零个或多个(懒惰)
将其从捕获组中提取出来.它应该在你的第一个捕获组中.请记住,整个数组存储在0匹配的索引中.
var match = myRegexp.exec(input);
alert(match[1]);
请在此处阅读有关正则表达式的更多信息,并使用debugexx.com进行实验.
| 归档时间: |
|
| 查看次数: |
4632 次 |
| 最近记录: |