标签: log-files
如何以友好的格式读取 pcap 文件?
pcap 文件上的一个简单的 cat 看起来很糟糕:
$cat tcp_dump.pcap

?ò????YVJ?
          JJ
            ?@@.?E<??@@
?CA??qe?U?????h?
.Ceh?YVJ??
          JJ
            ?@@.?E<??@@
CA??qe?U?????z?
.ChV?YVJ$?JJ
            ?@@.?E<-/@@A?CA??9????F???A&?
.Ck??YVJgeJJ@@.??#3E<@3{n??9CA??P???F???<K?
??`.Ck??YVJgeBB
               ?@@.?E4-0@@AFCA??9????F?P?????
.Ck???`?YVJ?""@@.??#3E?L@3?I??9CA??P???F?????
???.Ck?220-rly-da03.mx
等等。
我试图让它更漂亮:
sudo tcpdump -ttttnnr tcp_dump.pcap
reading from file tcp_dump.pcap, link-type EN10MB (Ethernet)
2009-07-09 20:57:40.819734 IP 67.23.28.65.49237 > 216.239.113.101.25: S 2535121895:2535121895(0) win 5840 <mss 1460,sackOK,timestamp 776168808 0,nop,wscale 5>
2009-07-09 20:57:43.819905 IP 67.23.28.65.49237 > 216.239.113.101.25: S 2535121895:2535121895(0) win 5840 <mss 1460,sackOK,timestamp 776169558 0,nop,wscale 5>
2009-07-09 20:57:47.248100 IP 67.23.28.65.42385 > 205.188.159.57.25: S 2644526720:2644526720(0) win 5840 <mss 1460,sackOK,timestamp 776170415 0,nop,wscale 5>
2009-07-09 …推荐指数
解决办法
查看次数
InnoDB:错误:日志文件 ./ib_logfile0 大小不同
在将一个数据库转换为使用 InnoDB 引擎后,我只是在 /etc/mysql/my.cnf 中添加了以下几行。
innodb_buffer_pool_size = 2560M
innodb_log_file_size    = 256M
innodb_log_buffer_size  = 8M
innodb_flush_log_at_trx_commit  = 2
innodb_thread_concurrency   = 16
innodb_flush_method = O_DIRECT
但它在第 2 行引发“ERROR 2013 (HY000): Lost connection to MySQL server during query”错误重启mysqld。并且mysql错误日志显示如下
InnoDB: Error: log file ./ib_logfile0 is of different size 0 5242880 bytes
InnoDB: than specified in the .cnf file 0 268435456 bytes!
100118 20:52:52 [ERROR] Plugin 'InnoDB' init function returned error.
100118 20:52:52 [ERROR] Plugin 'InnoDB' registration as a STORAGE ENGINE failed.
100118 20:52:52 [ERROR] …推荐指数
解决办法
查看次数
我的 /var/log/btmp 文件很大!我该怎么办?
我的/var/log/btmp文件大小为 1.3 GB。我读过该文件是“用于存储有关登录失败的信息”。
这对我的服务器意味着什么?我可以删除这个文件吗?
推荐指数
解决办法
查看次数
什么是“.well-known”文件夹?
如果在我们的日志文件中发现了一条新的错误消息并想知道这个.well_known-folder 代表什么。
哪个应用程序客户端需要访问这样的文件夹,哪个应用程序会在其中创建文件?
以下是我的域之一的 PHP 错误日志的一些条目。(我删除了日期、IP 和目标域)。
0000/00/00 00:00:00 [error] 851#0: *88611 access forbidden by rule, client: xxx.xxx.xxx.xxx, server: example.com, request: "GET /.well-known/apple-app-site-association HTTP/1.1", host: "exampleA.com"
0000/00/00 00:00:00 [error] 850#0: *89749 access forbidden by rule, client: xxx.xxx.xxx.xxx, server: example.com, request: "GET /.well-known/assetlinks.json HTTP/1.1", host: "exampleA.com"
0000/00/00 00:00:00 [error] 850#0: *89767 access forbidden by rule, client: xxx.xxx.xxx.xxx, server: example.com, request: "GET /.well-known/assetlinks.json HTTP/1.1", host: "exampleB.com"
0000/00/00 00:00:00 [error] 853#0: *90120 access forbidden by …推荐指数
解决办法
查看次数
我的 mysql 登录 OS X 在哪里?
我检查了 /var/log 和 /usr/local/mysql ,但似乎找不到日志。我正在尝试解决使用 php 函数建立数据库连接的错误。
推荐指数
解决办法
查看次数
如何完全记录所有 bash 脚本操作?
从我的脚本输出中,我想捕获所有带有错误消息的日志数据,并将它们全部重定向到日志文件。
我有如下脚本:
#!/bin/bash
(
echo " `date` : part 1 - start "
ssh -f admin@server.com 'bash /www/htdocs/server.com/scripts/part1.sh logout exit'
echo " `date` : sleep 120"
sleep 120
echo " `date` : part 2 - start"
ssh admin@server.com 'bash /www/htdocs/server.com/scripts/part2.sh logout exit'
echo " `date` : part 3 - start"
ssh admin@server.com 'bash /www/htdocs/server.com/scripts/part3.sh logout exit'
echo " `date` : END"
) | tee -a /home/scripts/cron/logs
我想查看文件中的所有操作 /home/scripts/cron/logs
但是我只看到了我在echo命令后放置的内容。
如何检查SSH命令成功的日志?
我需要收集所有日志。我需要它来监视脚本中每个命令的结果,以便更好地分析脚本失败时发生的情况。
推荐指数
解决办法
查看次数
Splunk 的替代品?
Splunk给我留下了深刻的印象,尤其是第 4 版。漂亮的图表、警报(仅限企业版)以及快速、准确的搜索。这是一个很棒的产品。
然而,成本太高,无法考虑为我们公司全面生产使用。我们真正需要的是能够在一个中心位置索引不同的日志,并对其进行合理的搜索。基于已保存搜索的警报也非常好。我们并没有真正超越这一点。
事实上,我们最大的用途是部署新的应用程序。一切都通过 log4net 记录到 Windows 上的事件日志或 Linux 上的文本文件。Splunk 使快速搜索这些内容变得非常容易,以确保应用程序的所有部分都正常工作——与寻找单个日志源相比,这为我们节省了大量时间。
这个市场有哪些替代品?我有一种下沉的感觉,Splunk 的定价如此之高,因为他们拥有迄今为止最好的产品,而且他们知道这一点。我们希望服务器在 Windows 上运行。
我对拆分模型持开放态度,将一种产品用于一般日志(通过 syslog/Snare 收集),并为我们的自定义应用程序(如Log4Net Dashboard)使用一种专用产品。
使用发送到 SQL Server(可能启用全文)的简单系统日志服务器(例如 Kiwi)是否可行?
我希望成本应该远低于 5 位数,美元。(是的,我知道,我们很便宜。我们是一家资金很少的初创公司,而 BizSpark 负责我们所有的 MS 许可。)
编辑:我应该补充一下,我们有大约 10 台物理服务器、20 台虚拟机以及几个防火墙和交换机。90% 是 Windows。
推荐指数
解决办法
查看次数
syslog、rsyslog 和 syslog-ng 有什么区别?
我对 syslog、rsyslog 和 syslog-ng 有点困惑。
我可以从哪里获得 的源代码syslog()?
rsyslog 和 rsyslogd 之间有什么区别吗?
推荐指数
解决办法
查看次数
如何实时监控Windows日志文件?
已经有一个关于打开大型日志文件的问题。
但我的意图不同。是否有任何应用程序可以监控日志文件并在它实时更新时进行更新?
基本上,与tail -f log_fileUnix 系统上的功能相同
平台: Windows XP/2003/2008 服务器
[更新]这对于快速监控非常方便(感谢 Ckarras 的回答)
PowerShell 的快速屏幕截图type -wait(类型是 的别名get-content)
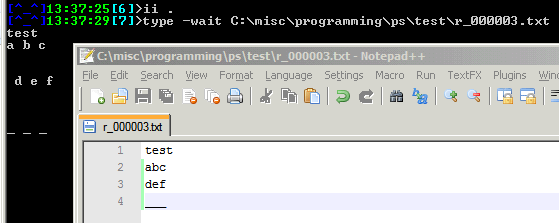
推荐指数
解决办法
查看次数
了解 Postfix 日志文件条目
我们有一个 Postfix 中心,我正在努力更好地理解 mail.log 文件中的信息。我使用 qshape、pflogsumm.pl 和 amavis-logwatch 等工具来汇总日志文件,但我对原始日志文件的某些元素仍有疑问。
我的第一个问题是关于最终发送电子邮件时 Postfix 出现的延迟条目。我猜这些值以秒为单位,但这些信息究竟意味着什么。
delay=2.4, delays=0.18/0.01/1.4/0.81
处理电子邮件总共需要 2.4 秒吗?
延迟部分的时间细分是什么?
推荐指数
解决办法
查看次数