标签: panel-data
线性模型面板OLS:带星星的回归输出
我正在使用 linearmodels 包来估计 Panel-OLS。例如,请参见:
import numpy as np
from statsmodels.datasets import grunfeld
data = grunfeld.load_pandas().data
data.year = data.year.astype(np.int64)
# MultiIndex, entity - time
data = data.set_index(['firm','year'])
from linearmodels import PanelOLS
mod = PanelOLS(data.invest, data[['value','capital']], entity_effect=True)
res = mod.fit(cov_type='clustered', cluster_entity=True)
我想在 .tex 文件中导出回归的输出。是否有一种方便的方法可以在没有 CI 之类的其他信息的情况下使用置信度来格式化输出?该问题已在此处的标准 OLS 上下文中提出,但这不适用于“PanelEffectsResults”对象,因为我收到以下错误:
'PanelEffectsResults' object has no attribute 'bse'
提前致谢。
推荐指数
解决办法
查看次数
分组时间序列(面板)数据的交叉验证
我使用面板数据:随着时间的推移,我观察了许多单位(例如人);对于每个单元,我都有相同固定时间间隔的记录。
当将数据分成训练集和测试集时,我们需要确保两个集是不相交的和顺序的,即训练集中的最新记录应该在测试集中最早的记录之前(参见例如这篇博客文章)。
面板数据是否有任何标准的 Python 交叉验证实现?
我试过 Scikit-Learn 的TimeSeriesSplit,它不能考虑组,GroupShuffleSplit不能考虑数据的顺序性质,见下面的代码。
import pandas as pd
import numpy as np
from sklearn.model_selection import GroupShuffleSplit, TimeSeriesSplit

# generate panel data
user = np.repeat(np.arange(10), 12)
time = np.tile(pd.date_range(start='2018-01-01', periods=12, freq='M'), 10)
data = (pd.DataFrame({'user': user, 'time': time})
        .sort_values(['time', 'user'])
        .reset_index(drop=True))

tscv = TimeSeriesSplit(n_splits=4)
for train_idx, test_idx in tscv.split(data):
    train = data.iloc[train_idx]
    test = data.iloc[test_idx]
    train_end = train.time.max().date()
    test_start = test.time.min().date()
print('TRAIN:', train_end, '\tTEST:', test_start, '\tSequential:', train_end < test_start, …time-series python-3.x scikit-learn cross-validation panel-data
推荐指数
解决办法
查看次数
使用面板数据的ARIMA建模
我正在进行固定效果回归并且遇到自相关问题,为了解决这个问题,我正在使用预测,lmtest和plm包进行ARIMA建模.我的数据是一般的面板数据,看起来像这样,我正在尝试做一些ARIMA建模,但我很难将自回归项和移动平均值结合到使用plm包的固定效果回归中.这是我的尝试.
world_hour_fix =
    plm(WBGDPhour ~ broadband + resourcerents + education,
        data = hourframe, model = "within")

auto.arima(world_hour_fix$residuals)

# Series: world_hour_fix$residuals
# ARIMA(1,0,1) with zero mean
#
#     Coefficients:
#       ar1     ma1
#       0.403  0.3135
# s.e.  0.138  0.1586
#
# sigma^2 estimated as 0.4901:  log likelihood=-175.54
# AIC=357.09   AICc=357.23   BIC=366.4

auto.arima(world_fix$residuals)
我的问题是:如何将一个自回归项和一个移动平均值合并到我的回归中?
推荐指数
解决办法
查看次数
面板数据回归:稳健的标准错误
我的问题是这样的:我NA在计算强大的标准误差时应该得到一些值.
我正在尝试使用群集稳健的标准错误进行固定效果面板回归.为此,我跟随Arai(2011)的人.3遵循Stock/Watson(2006)(后来发表在Econometrica,有权访问的人).我想通过(M/(M-1)*(N-1)/(N-K) 对抗向下偏差来纠正自由度,因为我的簇数是有限的并且我有不平衡的数据.
类似的问题已张贴前[ 1,2 ]在计算器上和相关问题[ 3 ]的交叉验证.
Arai(以及第1个链接中的答案)使用以下代码进行功能(我在下面提供了我的数据以及一些进一步的评论):
gcenter <- function(df1,group) {
    variables <- paste(
        rep("C", ncol(df1)), colnames(df1), sep=".")
    copydf <- df1
    for (i in 1:ncol(df1)) {
        copydf[,i] <- df1[,i] - ave(df1[,i], group,FUN=mean)}
    colnames(copydf) <- variables
    return(cbind(df1,copydf))}

# 1-way adjusting for clusters
clx <- function(fm, dfcw, cluster){
    # R-codes (www.r-project.org) for computing
    # clustered-standard errors. Mahmood Arai, Jan 26, 2008.
# The arguments of …推荐指数
解决办法
查看次数
如何按个人采样/划分面板数据(最好使用插入符号库)?
我想对面板数据进行分区并保留数据的面板性质:
      library(caret)
      library(mlbench)

      #example panel data where id is the persons identifier over years
      data <- read.table("http://people.stern.nyu.edu/wgreene/Econometrics/healthcare.csv",
                    header=TRUE, sep=",", na.strings="NA", dec=".", strip.white=TRUE)

      ## Here for instance the dependent variable is working
      inTrain <- createDataPartition(y = data$WORKING, p = .75,list = FALSE)

      # subset into training
      training <- data[ inTrain,]
      # subset into testing
      testing <- data[-inTrain,]
      # Here we see some intersections of identifiers
      str(training$id[10:20])
      str(testing$id)
但是我想,在对数据进行分区或采样时,避免将同一个人(id)分成两个数据集。他们是一种从数据中随机采样/分区并将个体分配给相应分区而不是观察的方法?
我试图采样:
mysample <- data[sample(unique(data$id), 1000,replace=FALSE),]
然而,这破坏了数据的面板性质......
推荐指数
解决办法
查看次数
Python + Pandas差异的差异
我正在尝试使用Python和Pandas 执行差异差异(使用面板数据和固定效果)分析.我没有经济学背景,我只是想过滤数据并运行我被告知的方法.但是,据我所知,我明白基本的diff-in-diffs模型如下所示:
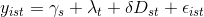
也就是说,我正在处理一个多变量模型.
下面是R中的一个简单示例:
https://thetarzan.wordpress.com/2011/06/20/differences-in-differences-estimation-in-r-and-stata/
可以看出,回归将一个因变量和树组观察值作为输入.
我的输入数据如下所示:
    Name    Permits_13  Score_13    Permits_14  Score_14    Permits_15  Score_15
0   P.S. 015 ROBERTO CLEMENTE   12.0    284 22  279 32  283
1   P.S. 019 ASHER LEVY 18.0    296 51  301 55  308
2   P.S. 020 ANNA SILVER    9.0 294 9   290 10  293
3   P.S. 034 FRANKLIN D. ROOSEVELT  3.0 294 4   292 1   296
4   P.S. 064 ROBERT SIMON   3.0 287 15  288 17  291
5 P.S. 110 FLORENCE NIGHTINGALE 0.0 313 3 …推荐指数
解决办法
查看次数
Keras LSTM 中的面板数据
我正在查看面板数据,其结构如下:
D = \{(x^{(k)}_{t},y^{(k)}_{t})\,|\, k=1,\dots,N\, , t=t_0,\dots,t_k \}_{k=1}^{N}
其中 x^{(k)} 表示第 k' 个序列, x^{(k)}_{t} 表示时间 的第 k' 个序列值 t,此外 x^{(k)}_{i,t} 是i向量中的第 ' 个条目x^{(k)}_{t}。即时间 'th 序列x^{(k)}_{t}的特征向量。子脚本和超级脚本对于标签数据的含义相同,但此处为.kty^{(k)}_{t}y^{(k)}_{t} \in \{0,1\}
简单来说:数据集包含随时间观察的个体,对于观察个体的每个时间点,记录他是否购买了物品(y\in \{0,1\})。
我想使用带有来自 Keras 的 LSTM 单元的循环神经网络来预测一个人是否会在给定的时间点购买某件商品。我只能找到每个序列都有一个标签值(philipperemy link)的 RNN 的例子,而不是我描述的问题中每个序列元素都有一个标签值的例子。
到目前为止,我的方法是创建一个具有维度(样本、时间步长、特征)的张量,但我无法弄清楚如何格式化标签,以便keras将它们与特征相匹配。它应该是这样的 (samples,timesteps,1),其中最后一个维度表示包含标签值 0 或 1 的单个维度。
此外,我遇到的一些方法是拆分序列,以便将子序列添加到训练数据中,从而极大地增加了对内存的需求(mlmastery 链接)。这在我的情况下是不可行的,因为我有多个 GB 的数据,如果我添加子序列,我将无法将它存储在内存中。
我想使用的模型是这样的:
mod = Sequential()
mod.add(LSTM(30,input_dim=116, return_sequences = True))
mod.add(LSTM(10))
mod.add(Dense(2))
有没有人有处理面板数据的经验keras …
推荐指数
解决办法
查看次数
plm或lme4用于面板数据上的随机和固定效果模型
我可以使用lme4在Panel Data上指定Random和Fixed Effects模型吗?
我从伍尔德里奇(2013,第494-5)在实施例重做14.4 - [R .感谢这个网站和这个博客文章,我已经在plm包中做了它,但我很好奇我是否可以在lme4包中做同样的事情?
这是我在plm包中所做的.非常感谢有关如何使用lme4进行相同操作的任何指示.首先,需要包和加载数据,
# install.packages(c("wooldridge", "plm", "stargazer"), dependencies = TRUE)
library(wooldridge)
data(wagepan)
其次,我估计使用plm包在例14.4(Wooldridge 2013)中估算的三个模型,
library(plm)
Pooled.ols <- plm(lwage ~ educ + black + hisp + exper+I(exper^2)+ married + union +
                  factor(year), data = wagepan, index=c("nr","year") , model="pooling")

random.effects <- plm(lwage ~ educ + black + hisp + exper + I(exper^2) + married + union +
factor(year), data …推荐指数
解决办法
查看次数
长/宽数据到宽/长
我有一个数据框,如下所示:
import pandas as pd
d = {'decil': ['1. decil','1. decil','2. decil','2. decil','3. decil','3. decil'],
    'kommune': ['AA','BB','AA','BB','AA','BB'],'2010':[44,25,242,423,845,962],
    '2011':[64,26,239,620,862,862]}
df = pd.DataFrame(data=d)
印花
decil      kommune  2010  2011
1. decil   AA       44    64
1. decil   BB       25    26
2. decil   AA      242   239
2. decil   BB      423   620
3. decil   AA      845   862
3. decil   BB      962   862
我想要的输出是这样的
 kommune  year  1. decil  2. decil  3. decil
 AA       2010        44       242       845
 AA       2011        64       239       862
BB 2010 25 423 962 …推荐指数
解决办法
查看次数
创建事件发生时间和事件发生后时间变量
我正在处理如下所示的面板数据:
d <- data.frame(id = c("a", "a", "a", "a", "a", "b", "b", "b", "b", "b", "c", "c", "c", "c", "c"),
                time = c(1, 2, 3, 4, 5, 1, 2, 3, 4, 5, 1, 2, 3, 4, 5),
                iz = c(0,1, 1, 0, 0, 0, 0, 0, 0, 1, 0, 0, 0, 1, 1))
   id time iz
1   a    1  0
2   a    2  1
3   a    3  1
4   a    4  0
5   a    5  0
6 b 1 0 …推荐指数
解决办法
查看次数
标签 统计
panel-data ×10
r ×5
python ×3
regression ×3
pandas ×2
python-3.x ×2
economics ×1
keras ×1
linearmodels ×1
lme4 ×1
lstm ×1
partition ×1
plm ×1
r-caret ×1
robust ×1
sampling ×1
scikit-learn ×1
statistics ×1
tidyverse ×1
time-series ×1