标签: graph-algorithm
如何在流程图上自动布局框?
我有一些代表流程图的数据.(一堆Jira状态及其向其他状态的转换.)
我还有一种粗略的方法将每个流程图项放在OpenOffice Draw文档的A4页面上.(虽然更好的建议值得欢迎.)
但是,我不想输出一行盒子并手动重新排列,特别是因为我可能需要多次重新生成流程图.
这似乎是一个常见的问题,因此必须有现有的算法/技术可以分析几个项目(以及它们之间的链接)并做一个体面的工作,将它们放在合适的位置.
有关如何最好地做到这一点的任何建议?
推荐指数
解决办法
查看次数
内联算法
有没有人知道任何论文讨论内联算法?并且密切相关,父子图与调用图的关系.
背景:我编写了一个编译器,Ocaml其中积极地内联函数,主要是由于这个和其他一些优化,它为我的编程语言生成比许多其他情况(包括偶数C)更快的代码.
问题#1:算法在递归时遇到问题.为此,我的规则只是将子项内联到父项中,以防止无限递归,但这会阻止兄弟函数一次性内联.
问题2:我不知道优化内联操作的简单方法.我的算法对于函数体的可变表示是势在必行的,因为它甚至不可能实现有效的函数内联算法.如果调用图是一棵树,很明显自下而上的内联是最佳的.
技术信息:内联包含许多内联步骤.问题是步骤的顺序.
每个步骤的工作原理如下:
- 我们通过用参数替换类型参数和值参数来制作要内联和beta-reduce的函数的副本.
- 然后,我们将return语句替换为对新变量的赋值,然后跳转到函数体的末尾.
- 然后,该函数的原始调用将替换为该函数.
- 但是我们还没完成.我们还必须克隆函数的所有子函数,并将它们进行beta减少,并将克隆重新复制到调用函数.
克隆操作使得内联递归函数变得非常困难.保持已经在进行中的列表并且只是检查我们是否已经处理此调用的常用技巧不能以天真的形式工作,因为递归调用现在被转移到调整后的代码中.函数,递归目标可能已更改为克隆的子项.但是,该子进程在调用父进程时仍在调用调用其子进程的原始父进程,现在不会停止展开递归.如上所述,我通过仅允许对孩子进行递归调用来打破此回归,从而防止内联的兄弟递归.
由于需要garbage collect使用未使用的功能,因此内联成本更加复杂.由于内联可能具有指数性,因此这是必不可少的.如果对函数的所有调用都是内联的,那么如果尚未内联函数,我们应该删除该函数,否则我们将浪费时间内联到一个不再使用的函数中.实际上跟踪谁调用极其困难的东西,因为在内联时我们不使用实际的函数表示,而是"解开"的表示:例如,正在按顺序处理指令列表并构建新列表,并且在任何一个时间点可能没有连贯的指令列表.
在他的ML编译器中,Steven Weeks选择使用多次重复应用的小优化,因为这使得优化易于编写且易于控制,但不幸的是,与递归算法相比,这错过了许多优化机会.
问题3:内联函数调用何时安全?
一般来说解释这个问题:在一个懒惰的函数式语言中,参数包含在闭包中,然后我们可以内联一个应用程序; 这是Haskell的标准模型.然而,它也解释了为什么Haskell这么慢.如果参数已知,则不需要闭包,那么参数可以直接替换其出现的参数(这是正常的顺序beta-reduction).
但是,如果已知参数评估不是非终止的,则可以使用急切评估:为参数分配表达式的值一次,然后重复使用.这两种技术的混合使用闭包但将结果缓存在闭包对象中.尽管如此,GHC还没有成功地生成非常高效的代码:显然非常困难,特别是如果你有单独的编译.
在菲利克斯,我采取了相反的方法.通过证明优化保留语义,而不是要求正确性并逐步提高效率,我要求优化定义语义.这保证了优化器的正确操作,但代价是不确定某些代码将如何表现.我们的想法是为程序员提供一些方法,以便在默认优化策略过于激进时强制优化器符合预期的语义.
例如,默认参数传递模式允许编译器选择是将参数包装在闭包中,用参数替换参数,还是将参数赋值给参数.如果程序员想要强制关闭,他们就可以传递一个闭包.如果程序员想要强制进行评估,他们会标记参数var.
这里的复杂性比函数式编程语言要大得多:Felix是一个带变量和指针的过程语言.它还有Haskell风格的类型.这使得内联例程极其复杂,例如,类型类实例尽可能替换抽象函数(由于在调用多态函数时类型特化,在内联时可能会找到一个实例,所以现在我们有了一个新函数可以内联).
为了清楚起见,我必须添加一些注释.
内联和其他一些优化,例如用户定义的术语缩减,类型类实例化,线性数据流检查变量消除,尾部rec优化,都是在给定函数上同时完成的.
排序问题不是应用不同优化的顺序,问题是订购功能.
我使用脑死算法来检测递归:我建立了每个函数直接使用的所有内容的列表,找到闭包,然后检查函数是否在结果中.请注意,在优化过程中,使用集会多次构建,这是一个严重的瓶颈.
函数是否递归可能会发生变化.尾部优化后,递归函数可能变为非递归.但是有一个更难的情况:实例化类型类"虚拟"函数可以使看似非递归的递归.
至于兄弟调用,问题是给定f和g,其中f调用g和g调用f我实际上想要将f内联到g中,并将g内联到f ..一次.我的无限回归停止规则是只允许将f内联到g如果它们是相互递归的,如果f是g的子,则不包括内联兄弟.
基本上我想"尽可能"地"平掉"所有代码.
algorithm ocaml compiler-theory compiler-optimization graph-algorithm
推荐指数
解决办法
查看次数
找到属于图的两个不相交子集的任何两个节点之间的最短路径
有一个无向图,其中每个节点都分配了一些颜色.我必须找到从任何蓝色节点到任何红色节点的最短路径.(其他颜色也可能存在于图表中,虽然它无关紧要,但不知道有多少颜色.)我怎样才能在多项式时间内完成?
推荐指数
解决办法
查看次数
解决问题列表所需的最少天数
编号为1..N的N个问题需要完成.你已经安排了增加难度顺序的问题,并且第i个问题估计了难度级别i.您还为每个问题分配了一个评级vi.类似vi值的问题在性质上是类似的.在每一天,您将选择一部分问题并解决它们.您已经确定当天解决的每个后续问题应该比您当天解决的上一个问题更难.另外,为了不让它变得无聊,你解决的连续问题应该在vi等级上至少为K.你可以解决所有问题的最少天数是多少?
输入:第一行包含测试用例数T.T测试用例如下.每个案例在第一行包含整数N和K,在第二行包含整数v1,...,vn.
输出:输出T行,每个测试用例一行,包含可以解决所有问题的最小天数.
约束:
1 <= T <= 100
1 <= N <= 300
1 <= VI <= 1000
1 <= K <= 1000
样本输入:
2
3 2
5 4 7
5 1
5 3 4 5 6
样本输出:
2
1
这是访谈街的挑战之一.
下面是我的方法
从第一个问题开始,找出最大可能的问题数量可以解决并从问题列表中删除这些问题.现在再次从剩余列表的第一个元素开始并执行此操作直到现在问题列表的大小为0我从这种方法得到错误的答案,所以寻找一些算法来解决这个挑战.
推荐指数
解决办法
查看次数
最接近的一对
在
http://en.wikipedia.org/wiki/Closest_pair_of_points_problem中,
我们可以看到它提到的最多6个点最接近另一半的点,可以表示如下图:
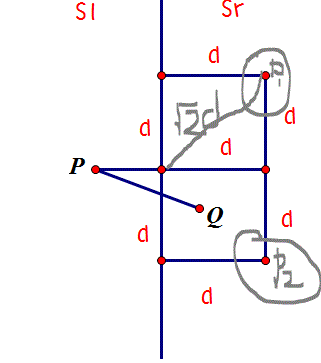
我的问题是针对点P1和点P2,到红点的距离将超过sqrt(2)*d,为什么它是解决方案的一部分?为什么不是最多4个点最接近P而不是最多6个点?谢谢.
推荐指数
解决办法
查看次数
用于在加权二分图上找到最优匹配的快速算法
我需要有效地解决分配问题(给定一个完整的加权二分图,选择最大总重量的完美匹配)并且我一直在使用这里的O(n ^ 3)版本http://community.topcoder.com/tc?module = Static&d1 = tutorials&d2 = hungarianAlgorithm.然而,我读过的一篇论文在"密集和稀疏线性分配问题的最短增强路径算法"中提到了一种"更有效的方法",这是一个付费墙背后的遗憾.有没有我应该注意的更快的算法(渐近,或者只是更小的常数/更均匀的内存访问或其他什么)?我正在使用浮点权重而不是整数权重,这对于匈牙利方法似乎并不重要,但对于更快的整数实现可能是一个问题.任何相关的链接将不胜感激.
推荐指数
解决办法
查看次数
2平面轮廓的曲面重建
在两个平面轮廓之间存在一类用于三角测量的算法.这些算法尝试进行"良好的三角测量"以填补这些轮廓之间的空间:

其中之一(平面轮廓的最佳表面重建)基于动态编程技术,并使用成本函数根据最小成本确定哪个三角测量是可接受的.
作为成本函数的最小三角形区域在大多数情况下(使用面积最小化的分支轮廓的三角剖分)产生了良好的结果,但不幸的是,并非所有情况都是如此.
例如,当您有两个相互偏移的矩形轮廓时.

如您所见,根据最小面积标准,来自轮廓\ alpha的所有点将连接到轮廓\β的点A,这是不正确的(正确的三角测量必须是通过两条曲线的"管",而不是两个四面体).
所以我的问题是:
1)是否存在任何处理两个轮廓的算法比基于动态编程的算法更好?
2)如果没有,成本函数的哪个标准可以提供更好的结果?
algorithm dynamic-programming triangulation computational-geometry graph-algorithm
推荐指数
解决办法
查看次数
arraylist的Arraylists作为关系的代表
我有几个值,如下所示:(连续的元素是关系.)
       Vertex relationships(edges)
    Source vertex   Destination vertex

    x1 26   y1 287   x2 154   y2 303
    x1 22   y1 114   x2 115   y2 185
    x1 26   y1 287   x2 375   y2 338
    x1 26   y1 287   x2 260   y2 393
    x1 115  y1 185   x2 121   y2 7
    x1 200  y1 101   x2 392   y2 238
    x1 99   y1 394   x2 375   y2 338
    x1 99   y1 394   x2 121   y2 7
    x1 274  y1 28    x2 22    y2 114
x1 …推荐指数
解决办法
查看次数
如何最小化同步N个副本的重新传输次数?
给定一组M个非同步副本,我们如何找到给定大小N的子集,以最小化在可靠的多播环境中同步其消息状态所需的消息重传次数(即 - 所有副本可靠地接收所有其他副本的消息)?
副本的消息状态由它们各自来自相同D源的消息组成(D> = M).对于每个源,副本具有来自该源的所有消息,直到某些最高序数(即 - FIFO,没有孔,从零开始).因此,副本的消息状态可以表示为序数向量,每个元素对应一个源.或者,如果您愿意,可以将副本的消息状态视为D维空间中的一个点.
假设所有M个副本已经交换了它们的消息状态向量,因此它们都具有所有消息状态的M行×D列的矩阵.因此,鉴于矩阵,现在这纯粹是一个集中的计算问题.
给出最佳答案的蛮力方法是检查所有(M选择N)子集并选择需要同步该子集所需的最小重传次数的子集.问题是这种方法在M中至少具有因子渐近复杂性.
我想知道是否有人知道或者可能会想到一个具有更好的渐近界限的最优算法?
最初,我正在考虑将其作为图论理论解决,其中复制品的消息状态是完全连接图中的顶点,其中边权重是两个端点的消息状态向量之间的曼哈顿距离.然后使用Prim算法跟随Kruskal算法进行min-link凝聚层次聚类,其中我们在任何聚类的大小等于或超过N时停止.
这可以在O(M ^ 2)时间内运行,但我可以构建反例,它不会立即产生最佳答案.例如,为简单起见,D = 1,让M = 7个复制品的序数为{0,2,4,14,15,16,19},N = 5.Kruskal的算法将聚类{14,15,16 ,19}和{0,2,4}然后在最后一步将这两个集群连接在一起.但我们想要的实际答案是将副本与状态{2,4,14,15,16}同步.也许我们可以在第一个合并的集群超过N然后尝试修剪它时停止?但是在这个例子中,我们又回来再次问原始问题,因为我们停止的集群实际上包含了所有M个副本!当然,当D> 1时,这个问题并不是那么简单,它总是(D> = M).
上述方法的另一个问题是,如果算法选择将两个副本群集同步到一个更大的群集中,那么这不仅会影响其他群集与新合并群集之间的距离(例如 - 就像在正常的凝聚层次聚类中一样),也是所有其他集群之间的距离,因为它们都听到并且可以从发送的任何重传中受益.因此,所有群集之间的所有距离都可以在每个合并步骤之后以非常简单的方式改变,如果您允许副本受益于此处接收的消息而不是FIFO,无孔顺序.例如,副本A具有从源D1到序号X的消息.算法选择同步两个副本群集,既不包括A,也需要从X + 5到X + 10的源D1重传消息.最优算法将意识到A可能从这些重传中受益,即使它们超出了他的FIFO,源D1的无孔序数,消息间隙为X + 1到X + 4.
我想到解决它的另一种方式是将其视为几何问题,其中M个复制品的状态代表D维L1空间中的点.然后我们想要找到包含至少N个点的最小"体积"凸包.这实际上可能不是一个好的方法,但几何上自然地考虑它可以捕获所有复制品可以从任何两组复制品同步中受益的想法.它们的大部分距离将缩小到由两个集合状态的合并创建的新对象的表面(而不是顶点!).
编辑 - 我想到的另一种方式来自我给出的例子.对于每个源DX,找到需要最少重传次数的N个副本的子集,以在该源上进行同步.这很容易.那么问题是你必须比较和修改这些D子集以使它们全部覆盖相同的N个副本.这不是一个完全形成的想法,因为每个维度DX中的最小N是全局空间中的局部最小值,可能在错误的区域中作为该维度的全局最优答案.无论如何,这是另一个想法.
EDIT2 - 回到Prim的+ Kruskal算法并忽略每个合并更新所有簇之间的相对距离,当我们发现大小等于或超过N的第一个簇时,最佳答案必须是某个子集那个集群?如果集群的大小等于N,那么我们就完成了.如果簇的大小超过N,那么我们可以做一些像计算簇的质心并选择N个最接近质心的复制品吗?这会产生最佳答案吗?这似乎仍然不正确,因为它没有考虑距离质心的各种距离的"方向性".也就是说,它不区分在D维空间中彼此接近的两个复制品(它应该支持),而不是相对于质心处于彼此"相反"方向的两个复制品.也许我们可以改为查看群集中副本的最小生成树,并以某种方式有效地修剪它以找到保持连接的最小权重子集?
任何想法或相关算法的指针将不胜感激!
推荐指数
解决办法
查看次数
Dijkstra的算法修改
让我们G (V, E)对一个W : E -> {0, 1, 2... W }非负整数使用具有非负权重函数的加权有向图
W。如何修改Dijkstra的算法以从给定的源顶点及时计算出最短路径O(V W + E)。
推荐指数
解决办法
查看次数
标签 统计
graph-algorithm ×10
algorithm ×8
geometry ×2
graph ×2
arraylist ×1
dijkstra ×1
flowchart ×1
java ×1
ocaml ×1
optimization ×1