问题列表 - 第318037页
C++中的数组和指针试图理解数组地址的含义
我试图了解数组地址的含义。
我写了下面的代码来尝试理解其含义,但我无法理解它:
char d [] {"Ashish"};

std::cout << d <<std::endl;

std::cout <<&d <<std::endl;

std::cout <<&d[0] <<std::endl;

std::cout <<(void*)&d[0] <<std::endl;
每个语句的输出是什么?为什么第二条和第四条语句的输出相同?
推荐指数
解决办法
查看次数
囚徒困境的奇怪结果
我尝试用 Python 实现囚徒困境,但我的结果并没有表明针锋相对是更好的解决方案,而是表明叛逃会带来更好的结果。
有人可以看看我的代码,并告诉我我在这里做错了什么吗?
import random
from colorama import Fore, Style
import numpy as np
# Define the actions
COOPERATE = 'cooperate'
DEFECT = 'defect'

# Define the strategies
def always_cooperate(history):
    return COOPERATE

def always_defect(history):
    return DEFECT

def random_choice_cooperate(history):
    return COOPERATE if random.random() < 0.75 else DEFECT

def random_choice_defect(history):
    return COOPERATE if random.random() < 0.25 else DEFECT

def random_choice_neutral(history):
    return COOPERATE if random.random() < 0.5 else DEFECT

def tit_for_tat(history):
    if not history:  # If it's the first round, cooperate
return …推荐指数
解决办法
查看次数
将自同态应用于一对中不同类型的元素
简而言之,我希望在 Haskell 中进行以下类型检查:
\nboth f (x, y) = (f x, f y)\n\nfoo :: ([Int], [Char])\nfoo = ([1], "a")\n\nbar :: ([Int], [Char])\nbar = both (concat . replicate 3) foo -- intended: ([1, 1, 1], "aaa")\n我收到的错误是:
\n\xe2\x80\xa2 Couldn\'t match type \xe2\x80\x98Char\xe2\x80\x99 with \xe2\x80\x98Int\xe2\x80\x99\n Expected: ([Int], [Int])\n Actual: ([Int], [Char])\n\xe2\x80\xa2 In the second argument of \xe2\x80\x98both\xe2\x80\x99, namely \xe2\x80\x98foo\xe2\x80\x99\n In the expression: both (concat . replicate 3) foo\n In an equation for \xe2\x80\x98bar\xe2\x80\x99: bar = both (concat . replicate 3) …推荐指数
解决办法
查看次数
C++ 将 std::chrono::utc_clock 格式设置为毫秒
我使用以下行来获取毫秒精度的时间:
std::stringstream s;
std::chrono::time_point<std::chrono::utc_clock> TimeTag = time_point_cast<std::chrono::milliseconds>(std::chrono::utc_clock::now());

s << format("{0:%F}T{0:%TZ}", TimeTag);
当我将其写入文件时,输出为(ns 精度):
2024-01-07T17:02:50.214000000Z
如何格式化不带尾随 0?
谢谢,约翰内斯
WWW 上的每个相关网站都告诉我使用上述说明,但结果总是带有尾随 0。
推荐指数
解决办法
查看次数
为什么“int”出现在“input”之前?我想了解这段代码的逻辑
我的老师给了我这个问题:编写一个读取整数并打印它的程序。所以我找到了这段代码:
integer_number = int(input("Enter an integer: "))

print("You entered:", integer_number)
我想了解为什么函数:“int”先于“input”
我希望“input”函数比“int”函数先出现,因为“input”具有向用户请求信息以便用户填写信息的功能,而“int”则将给定的字符串转换为整数。
推荐指数
解决办法
查看次数
Python 枚举如何强制只读访问?
据我所知,在Python中,常量是由大写变量名隐含的,但不是强制的。我还了解,通过从 Enum 子类化,类可以实现枚举类型,从而防止单个枚举值被覆盖。
在我看来,这两个习惯用法似乎有些不一致,我想知道 Enum 解决方案如何强制对变量值进行只读访问。
推荐指数
解决办法
查看次数
如何从图像中提取多个旋转形状?
我参加了一个在线视觉智商测试,其中有很多问题如下:
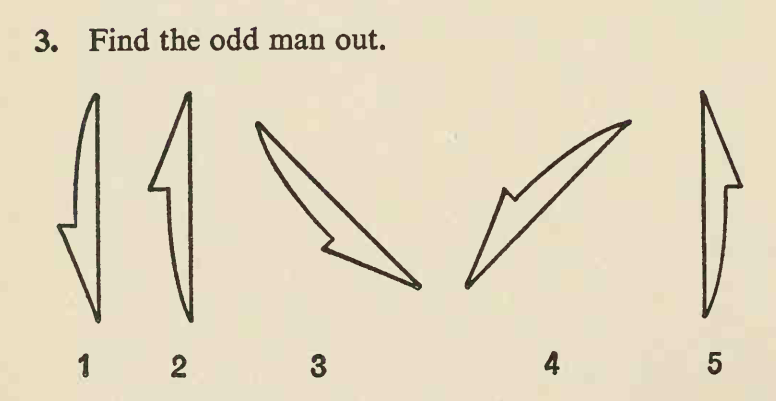
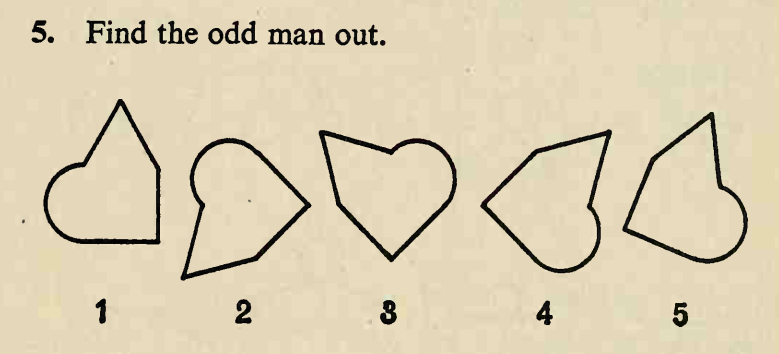
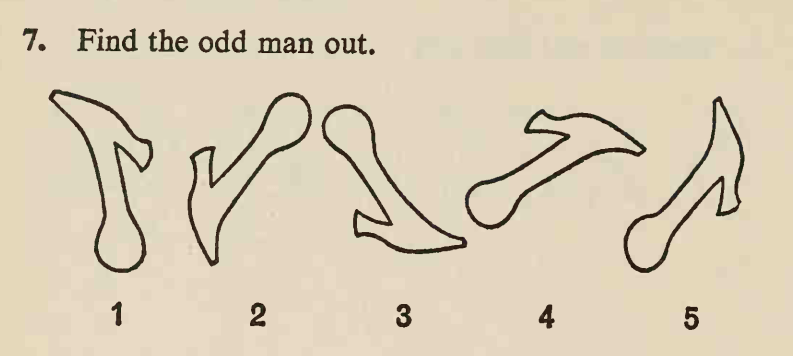
图片地址为:
[f"https://www.idrlabs.com/static/i/eysenck-iq/en/{i}.png" for i in range(1, 51)]
在这些图像中,有几个形状几乎相同且大小几乎相同。这些形状大多数都可以通过旋转和平移从其他形状中获得,但只有一种形状只能通过反射从其他形状中获得,这种形状具有与其他形状不同的手性,这就是“奇怪的人” 。任务就是找到它。
这里的答案分别是 2、1 和 4。我想将其自动化。
而我差一点就成功了。
首先,我下载图像,并使用cv2.
然后我对图像进行阈值处理并反转值,然后找到轮廓。然后我找到最大的轮廓。
现在我需要提取与轮廓相关的形状并使形状直立。这就是我陷入困境的地方,我几乎成功了,但也有一些边缘情况。
我的想法很简单,找到轮廓的最小面积边界框,然后旋转图像使矩形直立(所有边平行于网格线,最长边垂直),然后计算矩形的新坐标,最后使用数组切片来提取形状。
我已经实现了我所描述的目标:
import cv2
import requests
import numpy as np

img = cv2.imdecode(
    np.asarray(
        bytearray(
            requests.get(
                "https://www.idrlabs.com/static/i/eysenck-iq/en/5.png"
            ).content,
        ),
        dtype=np.uint8,
    ),
    -1,
)


def get_contours(image):
    gray = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)
    _, thresh = cv2.threshold(gray, 128, 255, 0)
    thresh = ~thresh
    contours, _ = cv2.findContours(thresh, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
    return contours


def find_largest_areas(contours):
    areas = [cv2.contourArea(contour) for contour in contours]
area_ranks = [(area, i) …推荐指数
解决办法
查看次数
为什么我们不能使用 ${$#} 来获取传递给 shell 脚本的最后一个参数?
我正在阅读 Richard Blum 和 Christine Bresnahan 的《Linux 命令行和 Shell 脚本圣经》。在处理不同特殊变量的部分中,例如$#和$@他们指出,尽管$#包含最终参数的索引,但它不能用于短路访问最终参数,如下所示:${$#}。相反,我们应该使用${!#}. 对于为什么会出现这种情况,没有给出太多解释,只是说明事实如此。
这一切都很好,我会记得我应该去做这样的事情 - 但是 bash 的机制中是否隐藏着一些更深层次的原因(或者甚至只是超出介绍性文本范围的功能)来解释原因${$#}不起作用?我花了一些时间在互联网上寻找答案,但没有找到太多答案。bash 的手册页谈到了它,但对我来说没有任何意义。
推荐指数
解决办法
查看次数
用于计数的函数或循环 - R studio
我正在练习我的 R 技能,我想知道是否有人擅长用于计数的函数或循环。我的想法很模糊,但我可以举个例子。
举个例子:
我有 4 个书架,一个叠一个。第一个(底部)架子可以放6本书,第二个架子可以放4本书,第三个架子可以放6本书,第四个架子可以放4本书。
我如何制作一个函数/循环,其中我的输入是我购买的书籍数量,输出是有多少书架已满。我希望系统从底部开始并向上运行。
我曾想过找出书架上可以容纳的平均书籍数量,但如果输入是 5,程序会认为第一个书架已满,但事实并非如此。
推荐指数
解决办法
查看次数
Perl 一行:替换中的捕获组被解释为八进制
假设我有一个包含文本的文件foo_bar_baz,并且我想将其替换为foo_bar_1234(这是更复杂问题的简化版本)。
第一次尝试:
 $ echo "foo_bar_baz" > testfile
 $ perl -pi -e "s/(foo_)(bar_).*/\1\2 1234/" testfile
 $ cat testfile
 foo_bar_ 1234
所以,我只需要去掉 之前的空格即可1234。显而易见的答案是
$ perl -pi -e "s/(foo_)(bar_).*/\1\21234/" testfile
...但这行不通。替换\212中包含八进制字符。我该如何解决?这里简要介绍了八进制问题,但我似乎错过了答案。该文档指出“Perl 通过将 \10 解释为反向引用来解决这种歧义,前提是在它之前至少有 10 个左括号”,但这里显然不是这种情况。此外,使用\g2or 并\g{2}不能解决问题。
我使用的是 Perl 5.34.0,bash 5.1.16。
编辑
该问题已被另一位用户回滚至修订版 3,但对该问题没有任何理解。最初的问题只有在 Perl 单行代码从 bash 脚本执行的上下文中才有意义;问题只是 Bash 和 Perl 之间对变量扩展的不同解释,以及单引号或双引号的使用。我没有 2K 代表,所以我无法滚动错误的编辑。
推荐指数
解决办法
查看次数