标签: failover
心跳:找出集群内机器的状态?
我正在尝试进行一些心跳调试。
有没有一种简单的方法来询问机器是否认为它是集群的一部分,以及它是主机还是从机?
我试过了
$ heartbeat -s
但它似乎只打印一个非常基本的状态 - 使用进程 ID 运行,或者不运行。
推荐指数
解决办法
查看次数
需要 Linux WAN 故障转移简单解决方案
我正在努力想出一个聪明而简单的 WAN 故障转移解决方案。这适用于具有两个不同外部 IP 的 SOHO 安装。只需要出站连接故障转移。
- 提供商 1:电缆
- 提供商 2:无线
防火墙是 Debian GNU/Linux,所以解决方案应该使用 Linux 并且是基于软件的。
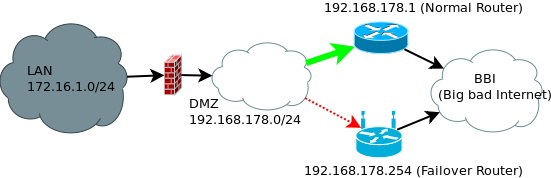
我希望不仅能够检测其中一台路由器是否出现故障(使用 iproute2 很容易),而且还能够检测它们的连接是否出现故障。两个路由器都没有 SNMP 或其他一些基于 RMON 的标准。
是否有类似于 ping 实用程序的东西,我可以在其中指定要使用的默认路由?
这样我就可以用一个小脚本以最佳方式监控两个链接。还是我应该走其他路线?
推荐指数
解决办法
查看次数
RAID 1 故障转移
给定(硬件)RAID 1 配置中的两个磁盘,当一个驱动器出现故障时,生产系统究竟会发生什么?
是否有任何明显的服务中断,或者系统会继续像往常一样只有一张磁盘,直到可以更换故障磁盘?(忽略因从两个磁盘变为一个磁盘而引起的任何微小的吞吐量变化)
推荐指数
解决办法
查看次数
多少故障转移冗余就足够了?
我正在开发一个客户端-服务器系统,其中所有客户端目前都将他们的交易提交到基本上一个单一的西海岸 IP 地址,以到达所谓的“网关”应用程序。网关进行一些记帐并将每个事务分派到多个数据库服务器中的任何一个进行最终处理。服务器将结果直接返回给客户端(而不是通过网关返回)。
计划是在东海岸添加第二个网关,用于冗余和故障转移。它通常仅处于备用状态,旨在在工作网关出现故障时接管并成为实际网关,本质上是此处所示的经典配置。
一些参与者认为只有一个备用网关是不够的,我们还应该实施第二个备用网关,比如在中西部。其他人则争辩说,两个备用站的额外成本、复杂性和管理是不必要的,并且两个海岸上网关同时不可用的可能性大到不必担心。
什么被认为是最佳实践?多少冗余(就客户端可用的物理独立接入点而言)通常被认为是名义上的?双重故障是否足够普遍,以至于经常会后悔只有一个备用?
编辑:关于“计算”成本与我需要或想要的冗余量的收益,我想最好将我的问题改写为:
指示地理上不同的 IP 地址集合同时无法访问的频率的统计数据在哪里?
换句话说,像这样的表
On average, 1 west coast IP + 1 east cost IP
are simultaneously unreachable 1 day/year.
On average, 1 west IP + 1 east IP + 1 southern IP
are simultaneously unreachable 1 hr/year.
On average, 1 west IP + 1 east IP + 1 southern IP + 1 northern IP
are simultaneously unreachable 1 minute/year.
etc.
使得选择所需的冗余量变得相当容易,因为有一个实际基础来计算成本与性能。(我猜“同时无法访问”必须意味着“大量随机分散在全国各地的客户端”,因为单个客户端可能无法访问任何服务器,无论有多少服务器,因为她自己的本地网络故障。)
但是,如果没有这样的表,任何冗余与性能计算都只是猜测。那么: 是否有任何现实生活可用性数据的来源可以作为此类计算的基础? 还是每个人都只是猜测他们需要什么,并在发现他们猜得低时根据需要进行扩展,或者如果他们猜得高就减少?
提供容错产品的公司似乎希望收集和推广此类数据。另一方面,也许数据会显示 99.99% 的容错客户根本不需要太多冗余。例如,如果我可以使用一整年并且我的东部和西部 IP 地址永远无法同时访问,我就不会考虑添加中西部 …
推荐指数
解决办法
查看次数
高可用性如何工作?
我不明白如何为我非常简单的场景设置故障转移。我正在为 API 构建服务网关。我想要的是两台服务器托管在不同的数据中心. 而且我只是希望用户能够在其中一台服务器停机的情况下访问该服务。数据库同步没有问题,我只关心服务的可用性。
我该如何做到这一点,同时防止用户在他们的一端实施任何类型的故障转移逻辑?我希望为用户提供单个域或单个 IP 地址,并且能够始终使用该单个端点访问该服务。
我不明白这是如何实现的。我知道我可以设置一个网络节点,将请求转发到第一台或第二台服务器,具体取决于这两个服务器中的哪一个当前在线。但是,我没有看到这个设置如何解决 HA 问题,因为我们刚刚向系统引入了一个单点故障 - 转发节点。因此,如果此节点出现故障,则该服务将不可用。
你能解释一下如何在现实世界中实现这一点吗?是否有可能以合理的成本实现这一目标(即不超过托管服务器本身的成本).
编辑:有人建议不同的数据中心要求是昂贵的。因此,请随时为 1 个数据中心内的 2 个服务器提供建议。
编辑 2:请随意提及该设置的合理成本。
推荐指数
解决办法
查看次数
ZFS:处理大量数据。并发 RW 操作和故障转移
我有一个 ZFS/Linux 实例,其文件可以增长到 ZFS 支持的疯狂大小。
大量并发用户需要通过公共互联网读取/写入该文件。如何在具有相同文件系统数据和元数据的 ZFS/Linux 实例池中平衡如此庞大的文件访问负载?
另外,虽然 ZFS 可以从轻微的位腐烂中自我修复,但在出现总体硬件故障时如何实现故障转移到 ZFS/Linux 实例的复制集?
似乎没有人谈论 ZFS 上下文中的副本、故障转移和负载平衡。或者也许,我在互联网上搜索的时间还不够长。
推荐指数
解决办法
查看次数
消除网络服务器的单点故障?
我知道在 DNS 中,每个 DNS 服务器都会尝试查看它们是否会响应
我在电子邮件中知道,如果发生故障,它将转到列表中的下一个,或者将邮件保留一段时间
据我所知,在网络服务器中,浏览器将获取网络服务器 IP 地址之一并尝试它,如果失败,它将放弃。这样对吗?如果是这样,那么将流量从出现故障的 IP 地址引开的唯一方法就是使用 DNS 服务器,即使这样也不会立即更新。
推荐指数
解决办法
查看次数
如何为多播制定 iptables ALLOW 规则?
我有两台使用 ucarp 作为故障转移的服务器。在每台服务器上eth1:1都为 ucarp 的 keepalive 连接保留。
ucarp 使用目标 IP 作为多播地址224.0.0.18。
在 ucarp 主服务器上是eth1:1IP 192.168.245.2,在辅助服务器上是eth1:1IP 192.168.245.3。
题
我想在每台服务器上制定一个 iptables 规则,这样任何人都不会错误地使用这些 NIC。即放弃所有对 ucarp 的期望。
对于主服务器,这样的规则会是什么样子?
我假设这样的事情?
iptables -P INPUT -i eth1:1 -j DROP
iptables -A INPUT -i eth1:1  ? something with multicast ?  -j ACCEPT
推荐指数
解决办法
查看次数
通过 HDD 的 SSD 冗余
有没有办法保证使用 HDD 的 SSD 冗余?
Raid 1 是保证 HDD 冗余的最佳选择,但 SSD 太昂贵,无法通过 RAID 保证冗余。如果我将 SSD 与 HDD 结合使用,是否可以使用 HDD 作为故障转移设备来保证冗余,并延迟镜像 HDD 上的数据?(例如:数据应该每 5 分钟同步一次,而不是像 Raid 1 那样实时同步)。
推荐指数
解决办法
查看次数
Cisco ASA 从命令行强制故障切换
我有 2 条独立的流量路由到我的服务器。它们由故障转移 Cisco ASA5505 对提供服务。但是,如果我的主路由(或主 Internet 馈送)上的千兆交换机出现故障,ASA 将不会检测到这种情况并故障转移到备用路由。
为了解决这个问题,我可以很容易地从服务器检测到活动路由的故障。
棘手的一点:我可以运行控制台命令/批处理文件来启动此故障转移吗?
|===============|         |===============|
|   Internet    |         |   Internet    |  (No admin access, possibly not Cisco)
|    Route A    |         |    Route B    |
|===============|         |===============|
        |                         |
        |                         |
|===============|  heart  |===============|
|    ASA5505    |---------|    ASA5505    |
|===============|  beat   |===============|
        |                         |
        |                         |
|===============|         |===============|
|    Switch     |         |    Switch     |  (Not Cisco)
|===============|         |===============|
        |                         |
        |                         |
|=========================================|
|                  Server                 |
|=========================================|
推荐指数
解决办法
查看次数
标签 统计
failover ×10
redundancy ×3
linux ×2
raid1 ×2
cisco-asa ×1
cloud-scale ×1
debian ×1
firewall ×1
hard-drive ×1
heartbeat ×1
iptables ×1
isp ×1
replication ×1
ssd ×1
ucarp ×1
web-server ×1
zfsonlinux ×1