标签: architecture
地理数据库同步镜像
我们公司的一位架构师设计了一个基于64位SQL2005标准版同步镜像的解决方案,在物理(4个四核,32GB RAM)服务器和虚拟DR服务器(4个虚拟CPU,16GB RAM)之间的两个地理远程数据中心之间见证服务器(1 个虚拟 CPU)。两个数据中心的存储都是企业级 SAN。
前端应用程序面向 Web,具有混合读/写用法。
作为一名 DBA(在设计阶段没有咨询过他),我担心这种配置的设计以最大限度地减少冗余为主要标准,并且它不会作为现实世界的解决方案工作 - 网络延迟和虚拟性能box 会导致不可接受的响应时间吗?如果调用故障转移,则性能甚至会更差。
有没有人有类似设置的经验?
performance architecture mirroring database-mirroring sql-server
推荐指数
解决办法
查看次数
需要有关为 Moodle 构建可扩展架构的建议
我正在研究为基于 Moodle 的教育网站设计一个架构,它最初将为数千名用户提供服务,但需要能够发展以支持多个国家/地区的数十万到数百万用户。
我正在考虑使用负载平衡器将请求分发到多个 Web 服务器。网络服务器可以被一些服务静态内容和一些服务动态内容分开。然后就是写入一个mysql master节点,从slave节点读取。
什么样的负载均衡器适合moodle,我应该从其中一家供应商那里获得硬件负载均衡器解决方案,还是自己使用LVS或反向代理等开源解决方案构建一个?
我最初计划使用 apache 服务器来为网页提供服务,然后随着负载的增加,分为用于静态内容的 lighttpd 网络服务器和用于动态内容的 apache 应用程序服务器。如果需要,也将部署 gzip 压缩、squid 缓存、memcache 等内容。
对于 web 服务器硬件,我应该使用 one-u 单插槽服务器还是刀片解决方案?哪一个最终的运行和扩展成本更低?Supermicro 有一个有趣的产品,1u 机箱中的双服务器和 2U 机箱中的 4 个服务器和 infiniband。这里有人试过这些服务器吗?
对于存储,我应该使用 SAN 或 Sun 统一存储 7000 之类的存储服务器就足够了。对于 mysql 集群设置,我应该有两个不同的存储系统,一个用于主节点写入访问,另一个用于从节点读取?还是所有节点都应该有单独的存储?
由于这个网站可能会比较重读操作,那么mysql集群和存储设置应该考虑什么?
对于管理部分,我计划使用 dsh、ganglia、nagios、splunk、kickstart。
对于备份,我计划使用 LTO 磁带自动加载机。该站点将主要用于亚洲地区,因此夜间会有几个小时的低流量。备份 mysql 集群的最佳方法是什么?我可以暂时禁用写入并取出 master 来执行备份吗?
请告知您是否有建立这种可扩展网站的经验,我的大部分经验都是在使用大型 unix 机器或较小的独立 unix/linux 机器方面。所以这种横向扩展的实现对我来说是第一次。
谢谢
罗伯特。
推荐指数
解决办法
查看次数
帮助建立一个用于路由/防火墙/VPN 目的的服务器
我们目前正在组装我们自己的服务器防火墙/路由器。我们都将使用来自一个像瞻博网络或Watchguard的专用解决方案,但它会是一个很大更具成本效益的,如果我们使用,我们计划已经获得服务器的机器,来代替。
关于我们:我们是一个网站,在防火墙/路由器服务器(一个 Web 服务器和一个数据库服务器)后面有两台服务器。所有三台服务器都将运行Windows Server 2008 R2 x64。
请原谅我的图表的粗鲁(我知道它甚至在技术上还没有接近正确,但希望它能让我们的拓扑更清晰一些)...
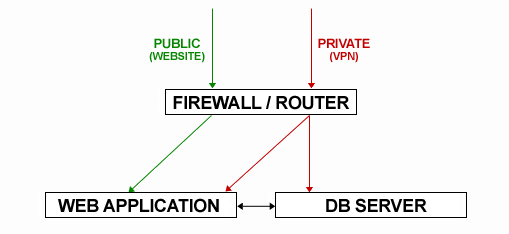
#1 路由
我们正在使用 RRAS 来配置我们的路由。目前,这被配置为为我们的 Web App 服务器提供互联网访问(通过 RRAS 的 NAT),但我需要设置端口转发,以便将任何对端口 80 的请求直接发送到 Web App 服务器。
#2 防火墙
Windows 高级防火墙是否可以接受我们要求的工作?(我想这个答案是肯定的。)
#3 VPN
到目前为止,设置 VPN 一直很痛苦(证书很烦人!)。我看过的每个教程似乎都有一个 DNS 和 DHCP 角色在他们的 VPN 机器上运行......这是为什么?它们都是必要的还是我可以将它们装箱?
总体
关于如何根据我们的需要配置此服务器的更多提示?
感谢您的任何建议。如果这是一个非常糟糕的问题,我很抱歉!(至少有赏金:)
推荐指数
解决办法
查看次数
优化数千个 SQL Server 数据库的性能
我们正在构建一个应用程序,其中每个客户端都有自己的数据库。没有一个数据库特别大(每个 20MB 到 400MB),但将有大约 5,000 个要启动,并且在任何时候都会有 100 个左右处于活动状态。
我们的团队一直在讨论如何最好地设置系统。客户每 2 周只访问一次他们的数据库(401k/财务处理),并且一次只使用 10-30 分钟。操作在读/写之间均匀分布。
我们团队中有一半人认为因此我们应该将数据库分布在多个便宜的服务器上并只使用 SQL Express ...他们说内存/缓存不会那么有用,因为每个数据库的使用时间都很短(我们在 1 台以上的服务器上没有完整 SQL 标准的预算)。
是这种情况吗?更高的内存限制确实是我看到 MSSQL Standard 给我们带来的唯一优势(我们已经有了用于执行备份/恢复、架构升级、迁移数据等的脚本)。
更新
我对多个数据库与一个数据库的性能特征特别感兴趣。使用单个 200MB 数据库的最终用户体验会不会比使用 1TB 数据库更好(即使两者都编入了良好的索引)?这也意味着我们可以非常快速地轻松备份/恢复单个客户端数据库,对吗?我们是否需要调整 SQL Server 以更好地处理“数千个数据库”的情况?
推荐指数
解决办法
查看次数
在集群环境中运行后台作业
我有一个架构问题。在集群的 web app 环境中,我可以想到三种方法来处理后台作业:
- 让一台专用机器运行所有作业,从而使 Web 服务器不必这样做
- 让每个 Web 服务器也运行后台作业,使用一种机制来确保没有两台机器启动相同的作业
- 让其中一台 Web 服务器兼作作业运行器
什么是首选方法?
推荐指数
解决办法
查看次数
对大型 Web 应用程序架构的建议?
这是一个大问题:)我们正在运行一个网站,其中 LAMP 并不大,5 个 Web 服务器具有 LVS 负载平衡,3 个 MySQL 服务器具有复制和读写分离,我们使用 Memcached 进行缓存和一些全文搜索工具。到目前为止,它运行良好,因为我们目前没有大量流量。
但是当用户快速增长时,我们将不得不扩展我们的架构以满足需求。也许会介绍分布式文件系统和数据库(以及并行计算?),以及一些集群和维护技术(如 Gearman 和 Pshell)。
网上有一些文章,我可以浏览一下。但是我真的需要一些实践经验来切实有效地准备这个问题。
推荐指数
解决办法
查看次数
Bash 无法启动已存在且具有所有正确权限的程序
这是一个gentoo服务器。有一个程序prog无法执行。(是的,执行权限已设置)
关于文件
$ ls
prog
$ ./prog
bash: ./prog: No such file or directory
$ file prog
prog: ELF 32-bit LSB executable, Intel 80386, version 1 (SYSV), for GNU/Linux 2.2.5, dynamically linked (uses shared libs), not stripped
$ pwd
/usr/local/bin
$ /usr/local/bin/prog
bash: /usr/local/bin/prog: No such file or directory
$ less prog | head
ELF Header:
Magic:   7f 45 4c 46 01 01 01 00 00 00 00 00 00 00 00 00
Class:                             ELF32
Data: 2's complement, …推荐指数
解决办法
查看次数
谷歌网络架构
我知道这个问题可能会被关闭为“不是一个真正的问题”、“主观的”甚至是“争论性的”。如果这是一个错误,我很抱歉。
我根本不擅长网络,但我正在努力变得更好并学习更多。(您可能知道这句话:“获得智慧的第一步是承认自己很愚蠢”:P)。
在我的浏览器中输入 www.google.com 并按 Enter 后,网络方面会发生什么?
这是我目前所知道的:
- 浏览器应用程序发出 DNS 请求以查找 www.google.com 的 IP。它可能会找到 209.85.148.105(这就是我现在刚刚解决的问题)。
- 然后它通过 TCP/IP 连接到端口 80(HTTP 的默认端口)上的主机,并发送一个 HTTP 请求,如 GET /
- 接收 HTML 数据并显示它(以及加载其他资源,如 .css、图像文件等)
我想知道的是它是如何一步一步连接到 Google 服务器的。在请求从我的计算机和我的 ISP 发出后,它最终会在某个时候访问 google 硬件。
- 有负载均衡器吗?
- 其中有多少?
- 是否有多个级别的负载均衡器?即:负载均衡器的负载均衡器的负载均衡器...
- 终端网络服务器有多强大?它会不会是一台糟糕的 500 MHz CPU 机器,配备 512MB RAM 和 10 GB HDD?或者也许是一个 8 核、16GB、RAID-0 SSD 野兽?
- 他们在网络级别使用什么样的冗余?
- 如果负载均衡器出现故障会怎样?
- 怎样才能使 www.google.com 不可用?(不,我不想破坏或……)
networking high-availability google load-balancing architecture
推荐指数
解决办法
查看次数
SAN 架构如何工作,更重要的是如何扩展?
我正在尝试了解一些 SAN 基础架构,我希望你们中的一些比我更有经验的人可以帮助我理解使用 SAN 进行扩展。
假设您有一些具有 HBA 的计算机服务器。它们直接或通过交换机连接到 SAN 控制器。然后,SAN 控制器提供一个或多个 LUN,这些 LUN 很可能映射到存储设备上的 RAID 阵列。
所以如果我理解正确的话,“控制器”代表了一个性能瓶颈。如果您需要大量性能,那么您可以添加更多控制器,这些控制器连接到它们自己的存储,然后映射到需要它们的服务器。
我想您可以获得一些具有巨大存储容量的非常高性能的控制器和具有较低最大性能的低性能控制器吗?但是,如果您有一个交换机,那么您可以根据需要向您的网络添加几个性能较低的控制器吗?
如果我错了,请撕毁我的理解,但我正在尝试弄清楚如何将 HBA 从服务器连接到存储,而不用简单地代表“魔法”的结构。
推荐指数
解决办法
查看次数
Kubernetes集群共享存储和备份解决方案
Kubernetes集群实现容器的共享存储持久化有哪些常见的共享存储方案?NAS / iSCSI 上的 NFS 不知何故?您如何使用这种类型的存储备份 Kubernetes 上的数据?
backup network-attached-storage storage-area-network architecture kubernetes
推荐指数
解决办法
查看次数
标签 统计
architecture ×10
sql-server ×2
apache-2.2 ×1
backup ×1
bash ×1
cluster ×1
controller ×1
executable ×1
gentoo ×1
google ×1
hba ×1
kubernetes ×1
linux ×1
mirroring ×1
moodle ×1
mysql ×1
networking ×1
performance ×1
routing ×1
scalability ×1
scaling ×1
tomcat ×1
web ×1
web-server ×1