问题列表 - 第5110页
如何按内存使用情况列出 systemd 服务
我想看看哪些systemd服务消耗最多的内存。
有没有办法按内存使用情况列出所有正在运行(和/或启用)的 systemd 服务?
推荐指数
解决办法
查看次数
X509 证书 - 有任何命名约定吗?
购买证书时的命名约定是什么(如果有)?
当为特定服务器购买 TLS/HTTPS 证书时,我自然会默认服务器的名称。例如,如果服务器名为 MOONSERVER,我会将x509 证书的主题设置为 MOONSERVER。
此外,我需要使用另一个证书进行消息签名。我应该怎么称呼这个?有效名称的规则是什么?例如,连字符、下划线等可以吗?名称区分大小写吗?
推荐指数
解决办法
查看次数
超出 SPF DNS 无效查找限制
在使用 port25.com 电子邮件服务测试我的 DKIM/SPF 配置时,我收到了以下 SPF 记录回复:
permerror(超出 DNS 无效查找限制)
但是,我的 spf 记录没有任何“包含”:
v=spf1 mx a ip4:IP1 ip4:IP2 ip6:IP3 ~all
知道发生了什么吗?
当我使用https://dkimvalidator.com/results 时,我通过了 SPF。
我已经在https://mxtoolbox.com/problem/spf/spf-void-lookups检查了文档, 并在这里找到了这个:
“无效查找限制是在 RFC 7208 中引入的,指的是返回空响应(没有答案的 NOERROR)或 NXDOMAIN 响应的 DNS 查找。”
它不是在做蚂蚁 DNS 查找,是吗?
推荐指数
解决办法
查看次数
RDS 是否/应该具有 VPC 之外的出口访问权限?
我做了一些挖掘,但很难找到一个明确的答案,因为 RDS 应该/是否需要任何形式的外部访问,即在 VPC 之外进行服务器更新、ntp 等?
假设它不是入口而是出口,即由 RDS 形成的连接?我的首选是“否”,但想仔细检查一下。
推荐指数
解决办法
查看次数
无法将 SQL_MODE 设置为 Mysql 8
我必须设置一个持久的自定义 SQL 模式持久到我的服务器。我在 /etc/mysql/mysql.conf.d/mysqld.cnf 中添加了这一行
[mysqld]
...
sql-mode = STRICT_TRANS_TABLES,ERROR_FOR_DIVISION_BY_ZERO,NO_AUTO_CREATE_USER,NO_ENGINE_SUBSTITUTION
当我尝试运行 mysql 时,出现以下错误:
2020-06-03T09:49:24.567568Z 0 [错误] [MY-000077] [服务器] /usr/sbin/mysqld:将值“STRICT_TRANS_TABLES、ERROR_FOR_DIVISION_BY_ZERO、NO_AUTO_CREATE_USER、NO_ENGINE_SUBSTITUTION”设置为“sql_mode”时出错。mysqld 版本 8.0.20-0ubuntu0.20.04.1 适用于 x86_64 上的 Linux ((Ubuntu))
我尝试更改sql-mode为sql_mode并删除双引号,但它没有改变。
推荐指数
解决办法
查看次数
如何在 Fedora CoreOS 上安装 docker-compose
我一直在 digitalocean 上使用 Fedora CoreOS 版本 31.20200505.3.0 (图片取自此处https://getfedora.org/coreos/download?tab=cloud_operators&stream=stable)
默认用户核心,但需要提升才能使用docker
使用命令通过二进制文件安装 docker-compose
curl -L "https://github.com/docker/compose/releases/download/1.25.5/docker-compose-$(uname -s)-$(uname -m)" -o ~/bin/docker-compose
chmod +x ~/bin/docker-compose
由于错误而不起作用:“[6261]加载Python lib'/tmp/_MEI7CUfMy/libpython3.7m.so.1.0'时出错:dlopen:libcrypt.so.1:无法打开共享对象文件:没有这样的文件或目录”
所以我尝试通过替代安装
curl -L --fail https://github.com/docker/compose/releases/download/1.25.5/run.sh -o ~/bin/docker-compose
chmod +x ~/bin/docker-compose
(作为 root)但是随后出现了无法访问的绑定安装的问题。使用此处的解决方案解决/sf/ask/1700203151/(添加:Z)到选项并修改 ~/bin/docker-compose shell 脚本因此。
但随后我收到错误“无法连接到位于 http+docker://localhost 的 Docker 守护进程 - 它正在运行吗?”
如果running docker-compose sh我docker run hello-world收到“docker:尝试连接到 unix:///var/run/docker.sock 处的 Docker 守护程序套接字时权限被拒绝:发布http://%2Fvar%2Frun%2Fdocker.sock/v1.40 /containers/create:拨打 unix /var/run/docker.sock:连接:权限被拒绝。请参阅“docker run --help”。”
此时我正在考虑其他容器发行版或 debian。
谁能指出如何在 Fedora CoreOS 上安装 docker-compose?
UPD:感谢 @Bert 提示,这解决了 docker-compose …
推荐指数
解决办法
查看次数
ansible:为什么我不能在剧本中使用 {{ ansible_facts['ansible_distribution_release'] }}
我有像这样在本地主机上运行的 ansible 任务
  - name: add docker repository
    apt_repository:
      repo: "deb [arch=amd64] https://download.docker.com/linux/debian {{ ansible_facts['ansible_distribution_release'] }} stable"
      state: present
      filename: docker-ce
我希望使用变量ansible_facts['ansible_distribution_release']来获取操作系统发行版名称,在我的例子中,它应该是buster。但它遇到了这样的错误
“该任务包含一个带有未定义变量的选项。错误是:‘dict object’没有属性‘ansible_distribution_release’
我尝试直接使用{{ ansible_distribution_release }},有效
repo: "deb [arch=amd64] https://download.docker.com/linux/debian {{ ansible_distribution_release }} stable"
然后我想我应该只直接访问事实,而不是作为变量 ansible_facts 的键来访问它,但是后来我阅读了官方文档,我看到了这样的用例
{{ ansible_facts['devices']['xvda']['model'] }}
这让我怀疑我对 ansible 变量的理解有问题
我试图不在, ie,ansible_distribution_release中引用,但没有运气[]ansible_facts[ansible_distribution_release]
我运行下面的命令
$ ansible localhost -m setup -a "filter=ansible_distribution_release"

localhost | SUCCESS => {
    "ansible_facts": {
        "ansible_distribution_release": "buster"
    },
    "changed": false
}
从而证明确实有一个名为ansible_distribution_releaseunder的属性ansible_facts。 …
推荐指数
解决办法
查看次数
为haproxy负载均衡器提供多个cfg文件
我的 haproxy 负载均衡器当前使用单个配置文件 /etc/haproxy/haproxy.cfg 运行:
ExecStart=/usr/sbin/haproxy-systemd-wrapper -f /etc/haproxy/haproxy.cfg -p /run/haproxy.pid $OPTIONS
我想将 haproxy.cfg 拆分为几个内容较少的文件,因为一些前端和后端定义可以使用 Ansible 和模板生成。我可以简单地将-f参数修改为吗/etc/haproxy/*.cfg?或者我应该将其指向一个专用目录,例如/etc/haproxy/conf.d?
还有一个额外问题。鉴于上述情况是可能的,并且我最终得到了许多具有不同前端和后端节的 cfg 文件,我是否仍然应该在每个 cfg 文件中包含全局和默认节?
推荐指数
解决办法
查看次数
AWS 快照自动化
抱歉这里有点新。我不得不接管一家拥有大约 10 个 ec2 实例的小公司的 aws。看起来实例每天都通过快照进行备份。目前有超过 400 个快照。我无法弄清楚它们是如何实现自动化的,因此我可以查看政策。
当我查看 Lifecycle Manager 时,目前没有政策。我还查看了 cloudwatch 中的事件,事件下没有规则。最后,我查看了服务器本身,看看是否有脚本通过 cron 运行而什么也没有。
所以我不知道这些快照是如何每天自动工作的?如果有人知道我应该在哪里找到它,将不胜感激。
推荐指数
解决办法
查看次数
调试 kmalloc-64 板分配/内存泄漏
我有两个配置非常相似的虚拟服务器:Debian bullseye(测试)、5.6.0 内核、512 MB RAM。它们都运行相似的工作负载:MySQL、PowerDNS、WireGuard、dnstools.ws 工作线程和用于监控的 Netdata。
仅在其中一台服务器上,不可回收的平板内存会随着时间线性增长,直到达到最大值(当服务器的内存已 100% 分配时):
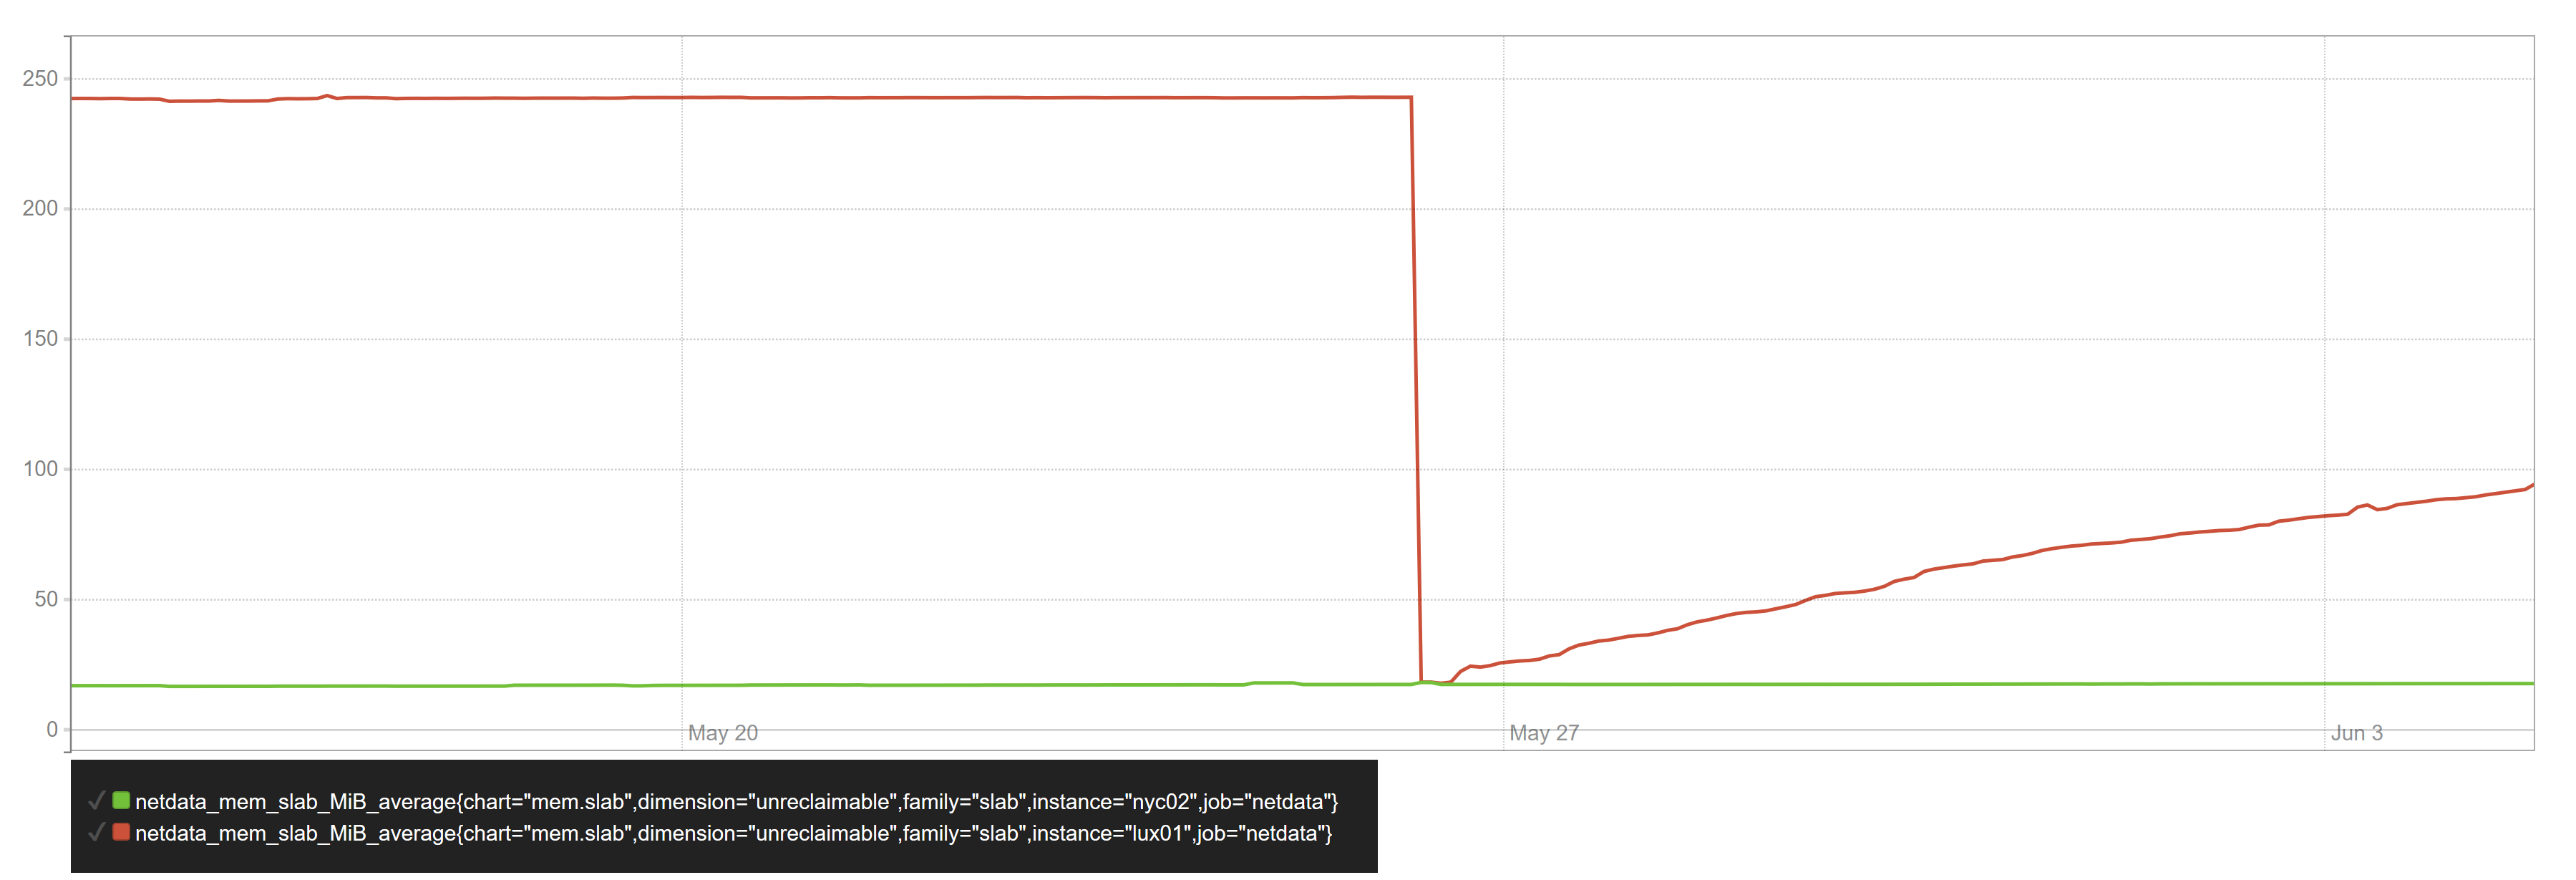
下降是当我重新启动 VPS 时。
slabtop在坏服务器上:
 Active / Total Objects (% used)    : 1350709 / 1363259 (99.1%)
 Active / Total Slabs (% used)      : 25358 / 25358 (100.0%)
 Active / Total Caches (% used)     : 96 / 124 (77.4%)
 Active / Total Size (% used)       : 113513.48K / 117444.72K (96.7%)
 Minimum / Average / Maximum Object : 0.01K / 0.09K / 8.00K

OBJS ACTIVE USE OBJ SIZE SLABS OBJ/SLAB CACHE SIZE …推荐指数
解决办法
查看次数
标签 统计
amazon-ec2 ×1
amazon-rds ×1
ansible ×1
certificate ×1
docker ×1
email ×1
haproxy ×1
linux ×1
linux-kernel ×1
mysql ×1
snapshot ×1
spf ×1
sql ×1
systemd ×1
x509 ×1